
AIが研究データを扱う時代に、研究開発の現場で本当に使えるデータ標準には何が必要なのか。標準化では、すべてを細かく決めればよいわけではない。実験の流れをどう表現するか、データとフローをどう分けるか、装置ごとに異なる項目をどこまでそろえるか。そして、実際の計測機器からデータを取り出し、現場で使い続けられる仕組みにできるか。
長年、計測・分析データの標準化に取り組んできた九州工業大学の安永学長に、研究開発で使える標準をつくるために重視してきた考え方と、その背景を聞いた。
安永卓生 九州工業大学学長プロフィール
1988年3月 東京大学理学部物理学科 卒業
1990年3月 東京大学大学院理学系研究科物理学専攻・修士課程 修了
1992年9月 東京大学大学院理学系研究科物理学専攻・博士課程 中退
1992年10月 東京大学理学部 助手
2001年11月 九州工業大学情報工学部 助教授
2008年4月 九州工業大学大学院情報工学研究院 教授
2022年4月 九州工業大学 理事・副学長
2026年4月 九州工業大学 学長
なぜ実験の流れを「ペトリネット」で表すのか
中野(AIST Solutions):実験工程をペトリネットで書くというのは非常に特徴的です。あまり馴染みがない方法ですが、なぜペトリネットでなければいけないのか、そのメリットを改めて教えてください。
安永学長:ペトリネットは、離散事象を表現するための仕組みです。ある事象に入力があって、何かが起きて、出力がある。それを記載できます。
計測分析や実験も、何かをするための入力があって、処理があって、出力がある。そう考えると、計測分析やその関連を表現するうえで非常に向いているのではないかと考えました。
一方で、ペトリネットそのものは非常に純粋で、プレースとトランジションという形でしか書かれていません。そこで計測分析に落とし込むときに、どうモデル化するかがポイントでした。私はCondition、Material、Resultという分け方をしました。
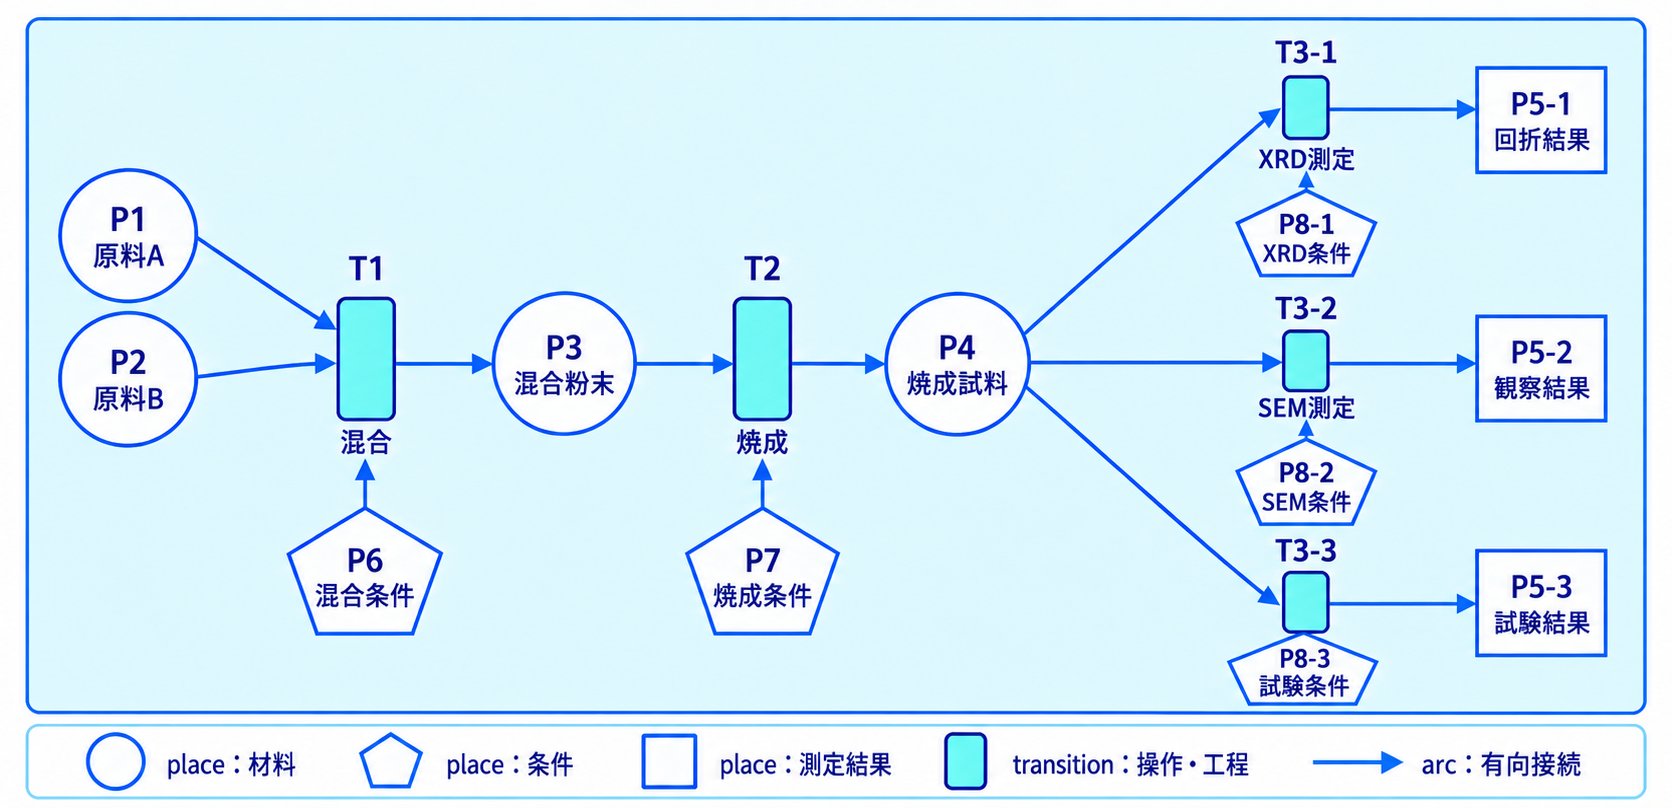
一番シンプルには、MaterialとConditionがあって、何らかの処理をするとResultが出る。ただ、製造のようなプロセスでは、処理した結果として次のMaterialが出てくる場合もあります。ある実験をして、その結果から次の実験条件が出てくるケースもある。そういう流れを表せるようにしたかった。
ペトリネットは並列もシーケンシャルな処理も両方記載できます。さらに、理論的にかなり汎用的なフローを表現できることが保証されている。保証されているものを活用しよう、というところが大きかったですね。
中野:情報工学のフロー表現を、材料や計測分析に合わせてモデル化した、ということですね。
安永学長:そうです。ペトリネット自体は古くから研究されていて、離散事象のフローを表現する非常に汎用的な方法です。そこにMaterial、Condition、Resultという種類分けを入れたところが、今回の設計のポイントだと思っています。
フローチャートやツリー構造では、なぜ足りないのか
中野:フローチャートやフォルダのようなツリー構造では駄目だった理由を、もう少しシンプルに教えてください。
安永学長:まずフローチャートは、並列を表現するのが難しい。もともと、一つの材料を複数の機器で計測分析するマルチモーダルな計測に対応できるように、という要求がありました。ですから、必ず並列が書けなければいけない。
私は状態遷移で書いた方が分かりやすいと考えました。ある状態にある材料やデータが、何かの処理を通して次の新しい状態になる。二つの材料を混ぜて次のものが出る、といったことも同じような形で表現できる。
フローチャートでやろうとすると、改めて決め事を作り直さなければいけない。でもペトリネットなら、すでに決め事があり、表現できる範囲も理論的に担保されている。それが大きかった。
中野:ツリー構造ではどうでしょう。
安永学長:ツリーは分岐は表せますが、本当の意味のフローになりきらない。ノードの先で止まってしまう。データを整理するものではあっても、プロセスを表現するものではない。私たちが欲しかったのは、プロセスを表現する仕組みでした。
ユーザーはペトリネットを理解しなくていい
中野:ペトリネットは、材料研究者が理解するには少し難しい面もあります。実際に使うユーザーは、ペトリネットを理解しておく必要がありますか。
安永学長:ユーザーは実は理解する必要がなくて、AIは理解できるんですよ。PNMLという形でXMLで表現されていて、仕様もすべて決まっています。AIにとっては学習できる範囲なんです。だからユーザーはそこを気にしなくても、裏側できちんと記載されていればいい。
実は標準を決めていく中では、「ペトリネットはいらないんじゃないか」という話もずっとありました。データやメタデータの必要性は皆さん感じられるけれども、フローの必要性は理解しにくい。ペトリネットも難しいので、なくていいんじゃないかと言われた。
でも、後からつながりを書くのは無理なんです。だからフローは必ず記載しておこうと考えました。
なぜデータとフローを「疎結合」にしたのか
中野:MaterialやConditionの中に、フローを直接書くこともできたと思います。なぜフローを外に出して分けたのでしょうか。
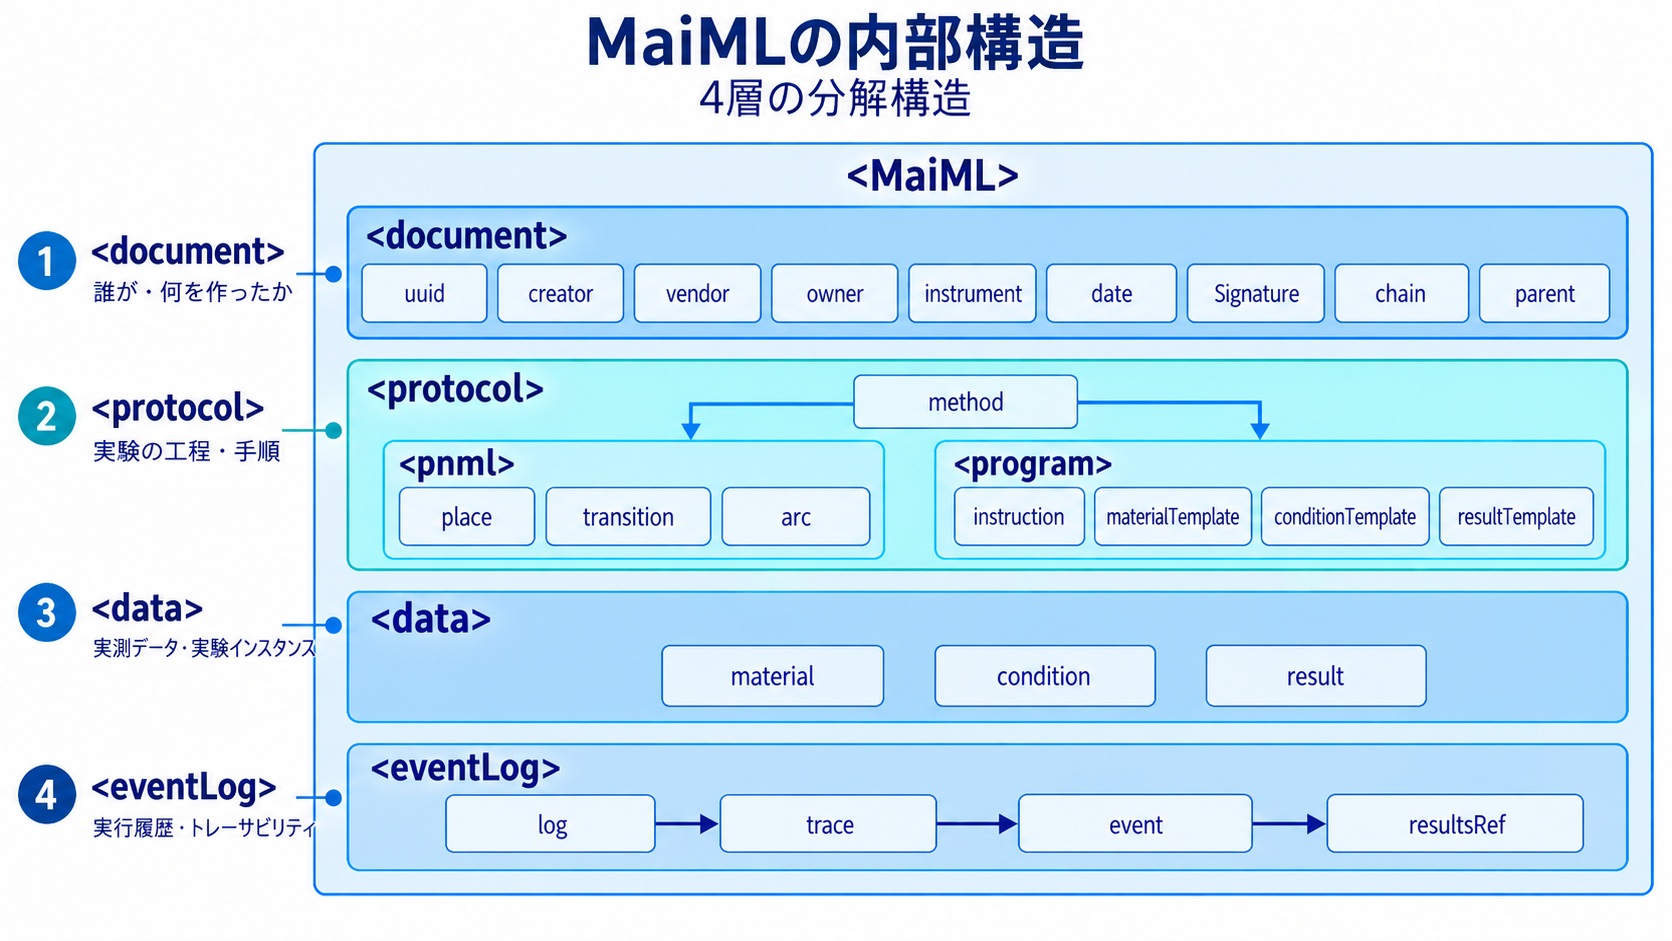
安永学長:疎結合にしておいた方がいいと考えたんです。つながりを少し緩くしておく。
ConditionやMaterialは、単体でデータやメタデータとして使うことの方が多い。もしその中にフローまで入れてしまうと、同じMaterialを別の実験で使いたいときに、また別のフローを書かなければいけなくなる。
フローを外に出しておけば、Material、Condition、Resultというデータやメタデータの塊を自由につないでいける。つなぐ役割はペトリネットに持たせればいい。プロトコルを設計する側と、実際に出てきたデータも切り分けています。
中野:AIに読ませるからこそ、分けておいた方が学習の定義もしやすい、という面もありますか。
安永学長:しやすいです。ハルシネーションも起こしにくい。プロセスはプロセスで学習するし、条件は条件、結果は結果で学習する。そうすればスモールデータでも、学習して結果を出すのが早くなるんじゃないか、という仮説もあります。
中野:そもそも疎結合にしたのは、将来AIが来ることまで見据えていたのでしょうか。
安永学長:正直に言うと、10年前にAIがここまで一気に来るとは思っていませんでした。ただ、AIのようなもの、コンピューターにとって使いやすいものは、お互いが分かれている方が使いやすい。変に複雑な形になっていない方がいい、という考えはありました。
データベースの基礎でいう正規化の考え方にも近いです。データが壊れないためには、できるだけ独立したデータとして持っていた方がいい。一緒にしてしまうと、何かを変えたら別のものも変えなければいけなくなる。フローが変わっても、元のデータを変えなくていい構造にしておきたかった。
中野:再利用性をかなり考慮していた。
安永学長:再利用性は一番気にしていました。同じものを同じものとして使えること。再現性も含めて、そこは重要でした。
時間情報も、データ本体から分けて残す
安永学長:Event Logも同じ考え方です。普通なら、このデータはいつできた、という情報をデータの中に書くかもしれない。でも、それも切り分けて、いつ取った、いつ始まっていつ終わった、ということをEvent Log側に残すようにしました。
例えば通常10分で終わるところが、あるとき15分かかっていた。材料を作るとき、普通は一晩なのに、学生が二晩にしてしまった。でもそれが成功した。そういうデータが残っていたら、いつ始めていつ終わったのかが重要になります。
時間の記録が残れば、どこがボトルネックなのか、どのステップに揺らぎがあるのか、といった分析にも使える。計測分析や材料を作る実験ワークフローにも、そういう考え方を入れたかった。
中野:順番やプロセスはフロー側で表現し、時刻はEvent Log側で表現する。そこも分けているわけですね。
安永学長:そうです。異なるものなので、分けておきましょうという形にしています。
生成AIで「人がデータ構造を読む」前提が変わった
中野:AIが読みやすい形を突き詰めると、人間との接点をどうするのかという問題も出てきます。人とAIが共存する間は、どう考えればいいでしょうか。
安永学長:それが、生成AIが出るまでは一番悩んでいたことです。見せるためのビューアを作らなければいけない、そういったツールがないと使ってもらえない、と考えていました。
でも今となってみると、対話型の生成AIそのものがそこをクリアしてくれる。自分が知りたいものを、知りたいように問いかければ、そのファイルから切り出してきてくれる。人が理解するために、裏側のデータ構造がどうなっているかを考えなくてよい時代がやってきたと思っています。
「全部決める」ことをやめた
| 区分 | 何を扱うか | 標準化の考え方 |
|---|---|---|
| 共通化するもの | 機械可読な構造・実験フローの骨格 | 異なる装置・研究で共有する基礎となる構造を定める |
| 現場に委ねるもの | 装置固有のキー・属性・新しい計測項目 | 各現場が必要な項目を追加できるようにする |
| 後からつなぐもの | 語彙や項目間の対応 | オントロジーやAIなどを使い、必要に応じて対応関係を整える |
中野:AI側は進化が速い一方で、計測機器ではメーカーごとにデータ形式が違ったり、制御できなかったり、読み出しできなかったりする状況が今も残っています。なぜ今でもそうで、どうしていけばいいと考えていますか。
安永学長:この10年はそれとの戦いでした。標準の中でキーや属性の意味を細かく定義していない理由もそこです。あそこの定義を始めたら終わらない。値を必ず出してください、と言っても終わらない。だから、せめて機械可読な形でカタログとして出してください、という考えにしました。
計測分析そのものがどんどん進化しています。全部を決めようとすると、決めるだけで時間がかかってしまう。ある時期に、「キーは決めなくてもいいです。自分たちで付けてください。それでいいから出してください」としました。
オントロジーとしてきちんとそろえなければ将来大変になる、という話もあります。ただ、それもAIのおかげで、近いものを見つけて対応関係を作ることができるようになってきています。すべてを先にそろえるコストを考えると、まずデータが出てくる方が大事だと思いました。
機器メーカーにとっても、データフォーマットを閉じておく方が得なのか、開いたフォーマットで出す方が使ってもらえて得なのか。それは各メーカーが競争の中で判断すればいい。私はユーザー側なので、出した方が得になる時代が来ているんじゃないかと思っています。
APIがあるかどうかで、装置の使われ方が変わる
中野:機器側の対応を待つより、AIエージェントが人の操作を代行して、記録を残す方が早いのでは、と感じることもあります。
安永学長:今度はそっちから押していく側だと思っています。では何が足りないかと考えたとき、電子顕微鏡でも大きな違いはAPIがあるかどうかです。
APIが公開されていれば、今となってはユーザーがプログラムを書けます。仕様のテーブルをAIに読ませて、「この条件でこう動かしたい」と言えば、APIをたたくプログラムまで作れてしまう。昔は私自身もそういうプログラムを何か月もかけて書いていましたが、本当に時代が変わりました。
RESTfulが本格化してから、考え方も変わりました。Webサーバを作って、APIでたたけば装置が動く。そうなれば遠隔だろうが何だろうが、あとはセキュリティの問題です。APIが開放されていれば、装置をソフトウェア側から自由に使える。
中野:日本の材料開発や計測機器で、DXの効果を十分に生かし切れていないとすれば、どこに課題があるのでしょうか。
安永学長:日本ではハードウェアが強いことですね。ハードとソフトが切り分けられすぎていて、どちらかというとハードウェアが強かった。
より良いものを作るというと、ハード側の性能を高めることが中心だった。一方で、海外の電子顕微鏡ではAPI駆動で装置を動かし、研究者が自分でソフトを書いて自由に動かせるようになってきた。日本の機器では、APIを持っていてもユーザーには公開しない、ソフト開発もメーカーにお願いする、という形が多かった。
ハードが進化しなければ最先端計測にはなりません。ただ、ソフトとハードの間が乖離していたことは大きかったと思います。バランスを変えるのに時間がかかっている、という感覚です。
成功データだけでなく、失敗も残す
中野:AIを活用するための基盤として、データをためる仕組みやプロダクトにはどんなことを期待されていますか。
安永学長:今の生成AIを作ったのは、ネット上に出てきた大量の文字情報です。計測分析を含めて、さまざまなことを推論するAIをフル活用するのであれば、整ったデータがある一定量以上あることが重要になります。
論文だと、ややもするとチャンピオンデータ一個の情報しか残らない。その裏側にある失敗も含めたさまざまなデータを取り出してくる仕掛けを作っていただきたい。失敗したというコードが入っていて、これはうまくいかなかった、こういうデータが出た、と残っていればいい。
例えば条件を桁違いに間違えたことで新しいものが出てきた、というようなケースもあります。人が「あれ?」と気づいて次に進んだことを、もしかするとAIが「あれ?」と言ってくれるかもしれない。そういうものまでデータとしてしっかり残っていくことが必要です。
さらに、データが出てくるだけではなく、今度はインプット側にうまく回せる仕組みになって、実験や製造へフィードバックできるようになる。そこがぐるぐる回り始めれば、次の新しい世界が広がると思っています。
標準は、作っただけでは広がらない
中野:標準化プロジェクトが一区切りした後をどう見ていますか。
安永学長:今の日本の仕組みだと、ISOを出して終わりになってしまうところがあります。だから、その次をどう継続するかが大事です。大学でも本格的にサポートしようという方向がありますし、そういうものがうまくつながっていく形が必要です。
ただ、そこにマネタイズは必要です。動かすためにですね。そこは悩みながら考えていく必要があると思っています。
インタビュー(2026年8月7日)
中野学:AIST Solutions プロデュース事業本部第二事業部マテリアルDX事業構想グループプロデューサ
