
生成AIの進化によって、研究開発におけるデータの意味が変わり始めている。データを蓄積するだけでなく、AIがその背景や前後関係までたどれる状態にしておくことが求められている。
長年、計測・分析データの標準化に取り組んできた九州工業大学の安永学長は、研究現場では「結果」や測定データは残っていても、そこに至る実験の流れが十分に残っていないと指摘する。AI-Readyな研究データとは何か。電子顕微鏡の研究現場で感じてきた課題から聞いた。
安永卓生九州工業大学学長プロフィール
1988年3月 東京大学理学部物理学科 卒業
1990年3月 東京大学大学院理学系研究科物理学専攻・修士課程 修了
1992年9月 東京大学大学院理学系研究科物理学専攻・博士課程 中退
1992年10月 東京大学理学部 助手
2001年11月 九州工業大学情報工学部 助教授
2008年4月 九州工業大学大学院情報工学研究院 教授
2022年4月 九州工業大学 理事・副学長
2026年4月 九州工業大学 学長
研究データは残っていても、フローが残っていない
中野(AIST Solutions):先生は長く計測・分析データの標準化に取り組まれています。背景には、研究の手順や条件が、紙でも電子化されていても個人の書き方に依存し、どういう手順で得られたデータなのかを後から追いにくいという課題があったと理解しています。
安永学長:基本的にはその考え方でいいと思っています。私自身の本来の専門に近いところは電子顕微鏡なんですけど、どうしても属人化してしまって、誰がどうやっているか、いろんな条件を含めて、そのフローが全く残らない感じになっているんです。まずはそれをしっかり残していこう、というところがありました。
フローとして残らないと、改善もまさに属人的になります。ある先生や、ある人の頭の中で次のステップを考える。でも、そういうものがたまってくると、新しい方法や計測方法、分析方法にもつながってくるんじゃないか。そういったものが残ることが大切だと思っていた、というのが一番大きいですね。
中野:取り組みを始められてから30年以上になると思います。その課題感は今も変わらないのでしょうか。
安永学長:その意味では変わらないです。
それぞれの研究者が論文を書いて、それをもとに再現することは普通に行われています。ただ、やはり足りていないところもありますし、それで大丈夫かということもある。再現性を含めて問題になってきています。
特に計測・分析では、フローごと残っているケースはほぼありません。もう少し電子ラボノートのようなものが広がるのかと思っていましたが、必ずしもそうなっていないし、その中にフロー的なものを標準的に記載する仕組みも、ほとんど整っていないように思います。電子ラボノート自体にも共通した標準があまりない。だから危機感としては相変わらずあります。
中野:ご自身の研究室では、標準化したデータ形式を実際の実験に使うところまで進んでいるのでしょうか。
安永学長:自分のところでは学生が中心なので、そのためのツール作りなどはやっています。ただ、現実の実験ツールとして使うところまでは、まだ十分に落とし込めていません。ある程度のものが出来上がらないと、日々の実験で使うところまではなかなかいかない。開発することと実際に使うことが完全には一致していない、というのが現状です。
中野:今、足りていないのはツール側ということですか。
安永学長:そうですね。逆に言えば、ベースになるものがようやくできてきた。ここからは、今の時代にどんなツールが必要なのかを改めて考える段階だと思っています。
データベースから、AI-Readyなデータレイクへ
中野:標準化が進み、ベースとなるフォーマットが整ってきました。今はどのような段階に来ていると見ていますか。
安永学長:ようやく、ベースになるフォーマットや、何の上でどう記載すればいいかというところが決まってきたので、ここから先はそれを活用していける段階に来たのかなと思っています。
それまでとは世の中も少し変わってきました。以前は、データを使うならデータベース化しましょう、データウェアハウスやデータマートのように整理されたデータでなければAIでは使いにくい、という考え方が強かった。
ところが昨今の生成AIを含めたAIの進化を見ると、データレイクのようにファイルが存在していて、それがXMLのような機械にとって読みやすい形になってさえいれば、AIが頑張って探したり、つないだりしてくれる時代になってきています。その意味で、必要とされるツールのあり方も変わってきていると思います。
中野:データを引き継ぐ相手が、人間だけではなくAIにもなってきています。以前とは要求されることも変わってきているということでしょうか。
安永学長:そうですね。AI-Readyな形としてデータが用意されるようになると、次のステップでは、その使い方自体が変わってくると思っています。
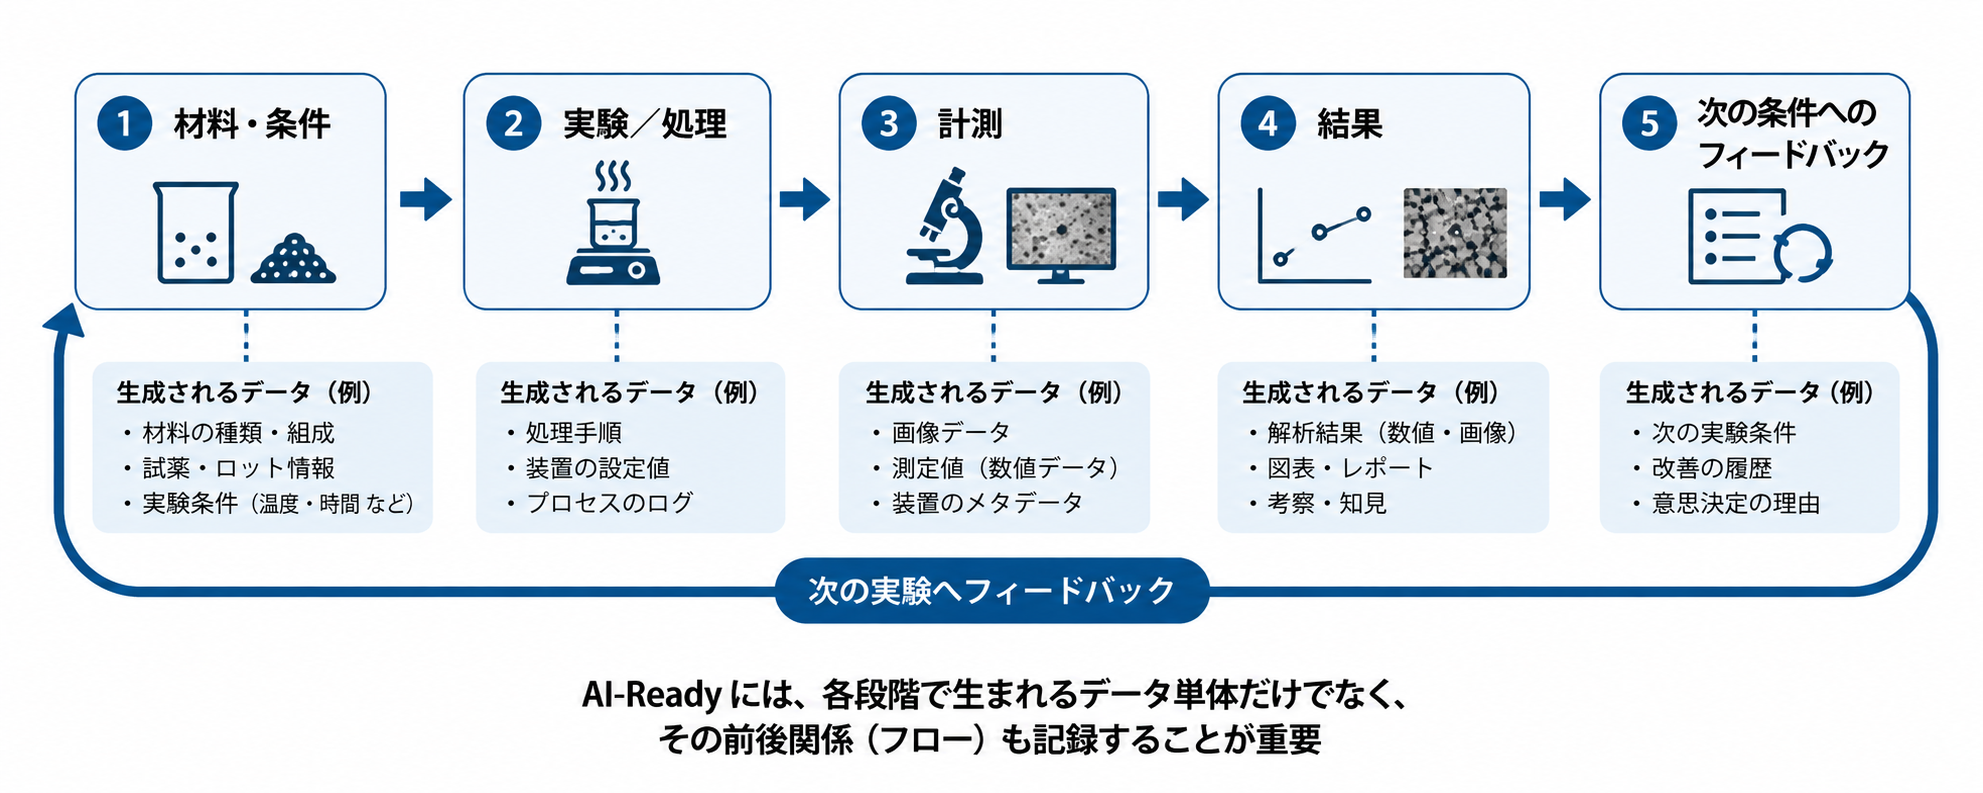
例えばワークフローそのものを研究することは、日本ではあまり行われてこなかったように思います。これまで「データ駆動」と言ったときには、データ、メタデータ、数値データ、画像データが中心でした。でもそれに加えて、何から何が出てきて、どうなったのか。材料を作るところから計測、その先のフィードバックまで含めてフローを記載できれば、そのプロセス自体を改善するという考え方が出てくる。そこはこれから重要になると思っています。
材料研究では、ある条件で作って、計測して、その結果を受けてまた条件を変える、という循環があります。その一連の流れを記録できれば、単にデータを解析するだけではなく、実験の進め方そのものを対象にできる。私はそこをプロセスエンジニアリングとして考えています。
聞き手:これまでは、そこを文書化して整理すること自体に人の時間とコストがかかっていました。一方で今は、AIが切り出しや整理を支援できる。研究者側は、蓄積されたデータとフローから何を取り出すか、何を問いかけるかにより集中できるようになるのでしょうか。
安永学長:そういう方向だと思っています。今までは研究者自身が、経験の中からどこを見るか、何を次にやるかを考えてきた。それが研究者の強みでもありました。そこもAIがサポートしてくれるようになるべきだと思っています。
データがあるだけでは、AI-Readyにならない
中野:AIならデータがどこかにあれば探してくれる、とも言われます。一方で、データをためるだけではAI-Readyにならないことも実際に起きています。何を押さえる必要があるのでしょうか。
安永学長:私は、一つはワークフローを含めたところで、ちゃんとカタログ化されていることだと思っています。
例えば私の場合なら電子顕微鏡です。電子顕微鏡で次々と写真を撮る。それを画像処理して、何かデータが出てくる。画像そのものはデータとしてたまっていきます。でも、その間がどうつながっていたかということは、きちんと記載されてこなかった。それは自分のノートの中だけにあったかもしれない。
それだけでは、そもそもどこが課題だったのか、何が問題だったのか、フローをどう変えれば次の新しい処理や製造につながるのか、というところまでAIが扱うことは難しい。今まではそこが研究者の強みだったわけですけれども、そこもAIがサポートしてくれるようになるべきだと思っています。
中野:文章や公開情報は大量にあるので、生成AIでもかなり扱えます。一方、実験では、その文脈を学習するデータ自体がもともとない。しかも企業の実験データは公開できるものでもありません。だから、自分たちがやっていることの文脈データを、自分たちでAI-Readyな形にして持っておかなければならない、ということですね。
安永学長:おっしゃるとおりです。
「文章は実は時系列なんですよね」
安永学長:なぜ生成AIで文章がこれだけうまくいっているのか。文章は実は時系列なんですよね。多少、倒置法のようなものがあったとしても、基本的には順番があります。
文章の良さは、そこにすでにフローがあることです。ところが画像などは点でしかなくて、そこにフローや流れ、時系列を入れ込むことが非常に難しい。
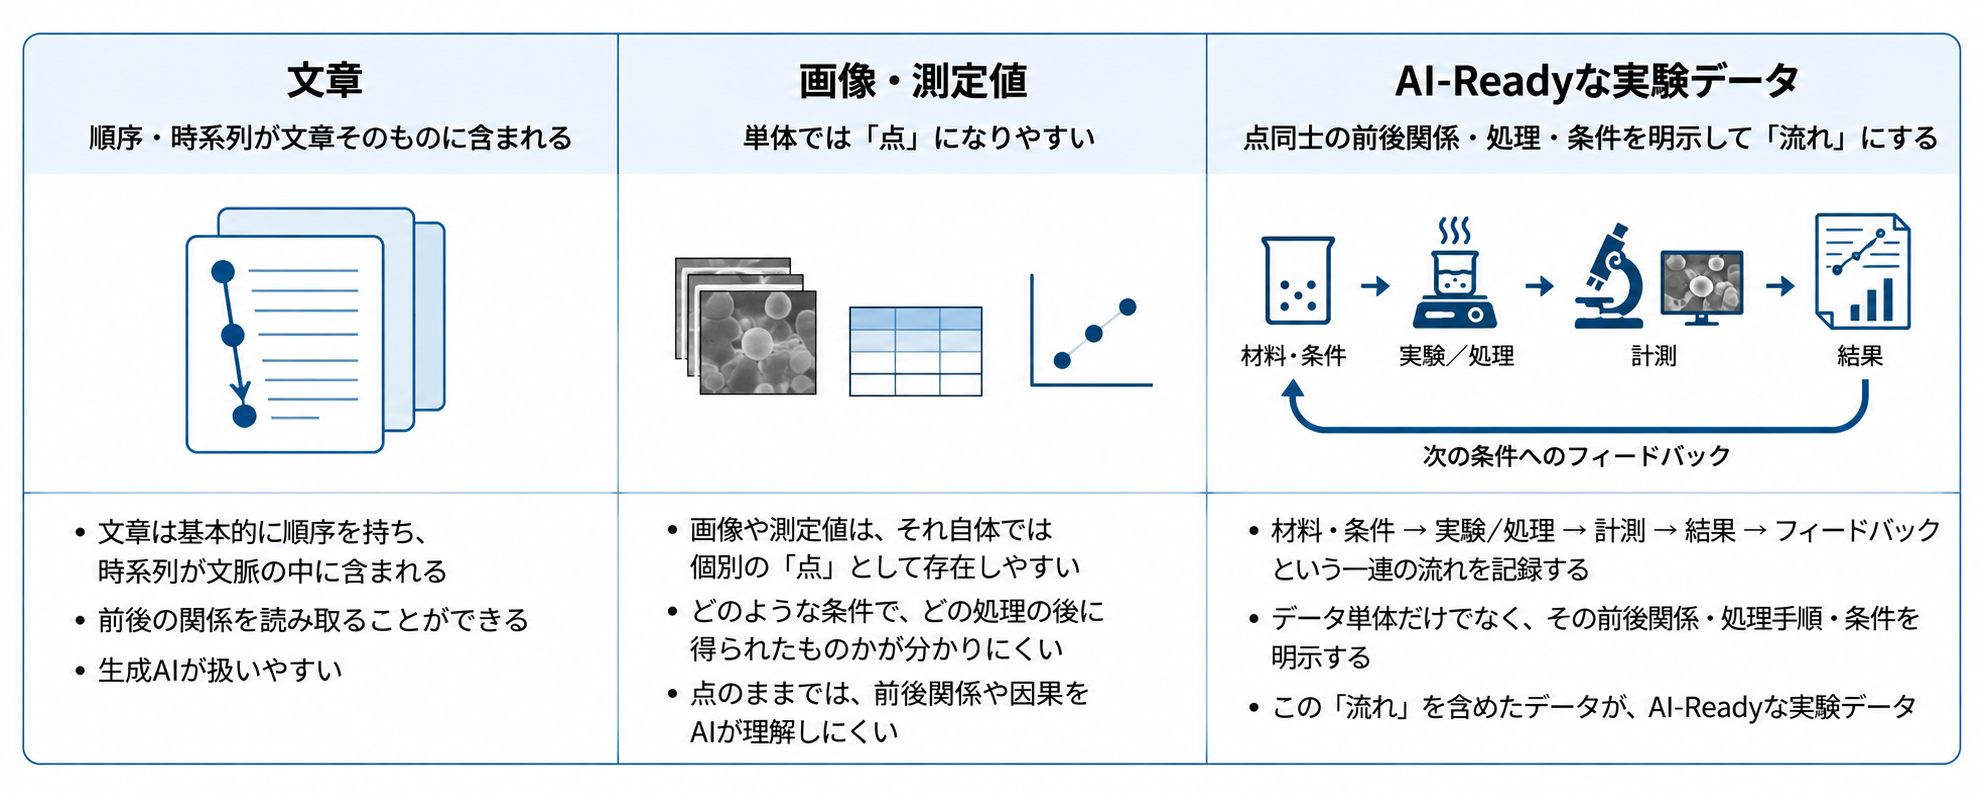
AIは相関は出せても因果関係を出すのが難しいとよく言われますが、その背景には時系列がないという問題もあると思っています。
計測・分析のデータやメタデータがつながって、新しいものを生み出していくためには、ある種の時系列をしっかり持っておくことが必要です。それがAI-Readyになるための条件なんじゃないかなと思っています。そういう意味で、プロセスエンジニアリングという言い方をしたりします。ワークフロー自身を研究する、計測分析のフローそのものをエンジニアリングする。材料を作るところから計測、その先のフィードバックまでフローを書けるようにして、そういったものをうまく活用する仕掛けが、これから必要なんだろうと思っています。
インタビュー(2026年8月7日)
中野学:AIST Solutions プロデュース事業本部第二事業部マテリアルDX事業構想グループプロデューサ
