
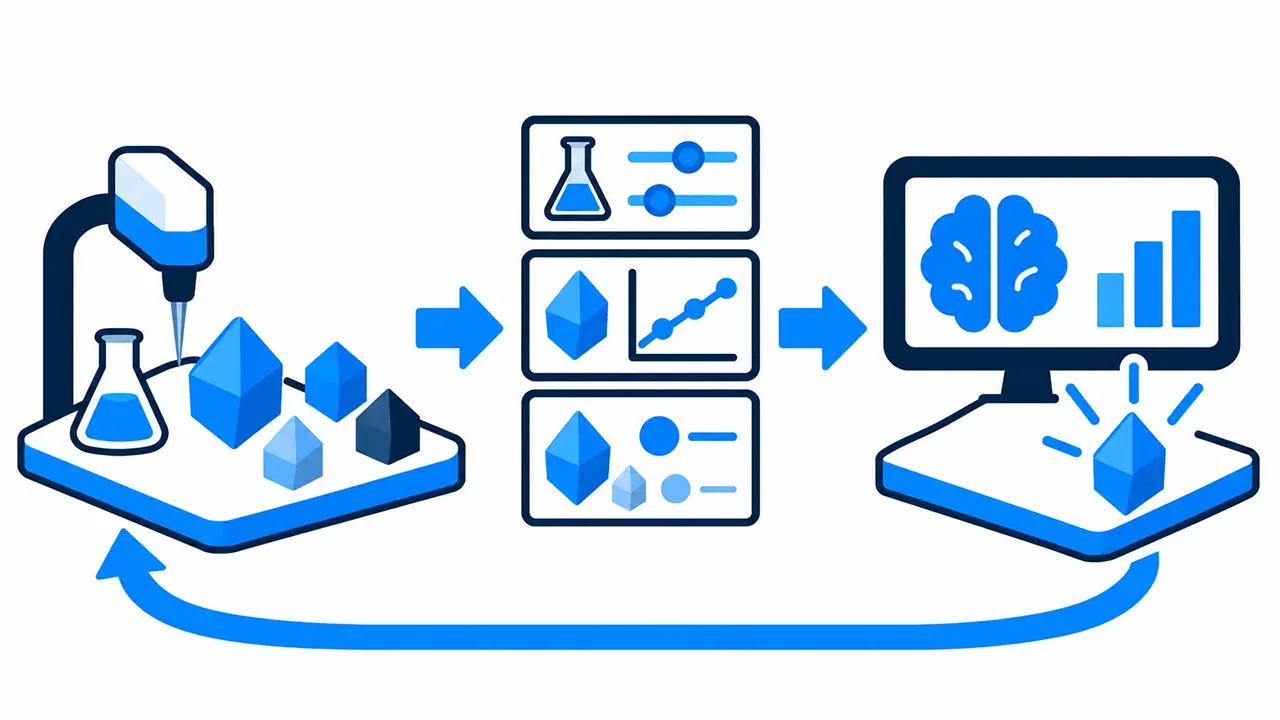
2026年、韓国の成均館大学などの研究チームが、AIを使って新しい固体電解質の合成条件を探る研究を発表した。AIが最初に提案した温度は600℃。ところが、実際に合成してみると目的の材料だけでなく、別の結晶相も現れた。
研究チームはその結果をAIに戻した。AIは温度を下げる条件を提案し、研究者は450℃、さらに400℃を試した。数回の試行を経て、不純物相が検出されない単一相の材料を得ることに成功した。AIは4,407本の公開論文から抽出した合成情報を検索して条件を提案し、実際の実験結果を次の提案に利用していた。[1]
注目したいのは、600℃で得られた結果である。それを単に「失敗」と片付けていたら、次に試す温度を考える材料の一つが失われていた。しかも有用だったのは「600℃ではうまくいかなかった」という言葉だけではない。何を使い、どのような手順で処理し、どんな相が検出されたかという情報が伴っていたから、次の条件を考えられたのである。
実験データを形づくる四つの文脈
材料研究では、同じ物質を扱っていても、配合、加熱温度、時間、雰囲気、装置の状態が違えば結果が変わる。同じ測定値でも、測定装置や解析方法によって解釈が変わることがある。
例えば、ある試料の性能が「80」と記録されていたとする。何を測った値か、単位は何か、試料はどの条件で作られたかが分からなければ、研究者もAIも次の実験に利用しにくい。目標値が100だったのか60だったのかによって、80という値の評価すら変わる。
実験データの「文脈」とは、結果の意味を決める周辺情報と、その結果に至る過程のつながりである。具体的には四つのまとまりとして考えられる。第一は材料・組成・温度・手順などの「条件」。第二は測定値や生成物、目標への到達度、判定理由を含む「結果と判定」。第三は生データ、測定・解析方法、誤差、変更履歴などの「来歴」。第四は、なぜその条件を試したのか、研究者の判断か無作為な探索かという「選び方」である。これは単一の規格の定義ではなく、複数の研究を踏まえた本記事の整理である。
2026年に『Precision Chemistry』誌に掲載された材料データベースに関する展望論文は、データの来歴、測定の不確かさ、条件情報、失敗結果の分類などを、AIの信頼性を左右する要素として整理している。[2]
| 文脈 | 残す情報 | AIでの用途 |
|---|---|---|
| 条件 | 材料・組成・温度・手順・装置 | 条件と結果の対応を学習 |
| 結果と判定 | 測定値・生成物・目標達成度・判定理由 | 結果の違いを比較 |
| 来歴 | 元データ・解析方法・誤差・変更履歴 | 品質と再現性を評価 |
| 選び方 | 試験目的・選定理由・無作為/人間の判断 | 選択の偏りを把握 |
同じ測定値でも、材料や条件、測定手順、実験を選んだ理由が違えば解釈は変わる。四つの情報は成功と目標未達の両方で共通して記録する。
同じ実験結果でも、文脈を残せば別の研究者が確かめたり、異なる結果と比べたりできる。AIが学ぶ対象も、単独の数値から「どの条件がどの結果に結び付いたか」という関係へ広がる。ただし文脈を多く記録すれば必ず予測が当たるわけではない。誤記録や測定誤差、データの偏りへの対処も必要である。
成功と失敗が描く、実験条件と結果の関係
研究成果として論文に残りやすいのは、新しい物質が得られた実験や、期待した性能が確認された実験である。一方、目的物が生成しなかった試行や性能が低かった試料は、論文に載りにくい。こうして公表される結果が偏ることを出版バイアスと呼ぶ。
ここで、二つの言葉を区別しておきたい。「ネガティブデータ」は期待した結果を得られなかった試行や低性能の結果などを指す。一方、「ダークデータ」は記録されていても十分に活用・共有されていないデータを指す場合が多い。後者には成功した実験の記録も含まれる。この二つは重なるが、同じ概念ではない。
成功した試行は、ある条件で狙った結果が得られることを示す。目標未達の試行も、同じ目的に対してどの条件が有望でないか、あるいは改善余地がどこにあるかを示し得る。重要なのは両者を同じ実験の記録体系に置き、結果の違いを比較できるようにすることである。失敗した実験がすべて有用という意味でも、成功と失敗のデータが同じ件数だけ必要という意味でもない。
データの問題は成功例への偏りだけではない。2019年の『Nature』論文では、公開された化合物の79%に、使用されたアミン系反応剤の17%が関わっていた。研究者が選びやすい原料や条件に実験が集中していたのである。研究チームが548件の無作為に設計した実験を行うと、そのデータを使ったモデルは、人間が選択したより大規模な実験データで学習したモデルを上回った。[3]
既存データへの集中と未探索領域の違いを説明した概念図であり、実測した件数分布ではない。
2022年に発表された研究者310人への調査では、回答者の87%が否定的な結果を保存し、66%が何らかの形で文書化していた。一方、学術誌で公表した経験がある人は12.5%だった。調査対象は主としてフランスの化学・物理・工学・環境科学の研究者であり、材料分野全体の比率ではない。それでも、データが「存在しない」ことと、「他の人が利用できる状態にない」ことを分けて考える必要を示している。[14]
研究者310人の調査。保存・文書化・学術誌での公表経験は異なる設問であり、割合を同一母集団の逐次的な減少率と解釈しない。
研究者の経験に基づく選択は大きな強みである。しかし、過去に選ばれなかった条件の情報が乏しければ、AIが学習できる範囲も限られる。「何を記録したか」と同時に「どのような考えで、その実験を選んだか」もデータを解釈する手掛かりになる。
89%の成功、781件の難題、成功と失敗の統合
成功と失敗を含む実験記録の活用は、最近始まった研究ではない。2016年、米国の研究チームは研究ノートに残る、目的の結晶を得られなかった水熱合成の記録を利用して機械学習モデルを作った。新たに試した条件で、モデルが選んだ実験の成功率は89%だった。[4]
この研究で使われたのは、成否のラベルだけではない。研究ノートの情報に化学的な特徴を表す数値を加え、反応条件と結果の関係を学習させた。過去に試したが成果として公表されなかった実験が、新たな材料の探索に使える情報になった。
一方、企業の実験ノートを集めれば同じように予測できるとは限らない。2023年の『Chemical Science』論文では、製薬企業AstraZenecaの電子実験ノート由来の781件の化学反応を分析したが、収率を十分に予測するモデルは得られなかった。比較対象のハイスループット実験データでは良い予測性能を示したモデルでも、実際の研究記録では性能が低下した。[5]
2026年の『JACS Au』には、成功と失敗の両方を一つのデータセットとして活用した研究が掲載された。対象は共有結合性有機構造体(COF)という多孔質材料である。研究チームは、研究室に残された失敗した合成1,822件と、論文から取り出した成功例2,603件を整理し、溶媒や合成条件の予測モデルを作った。[15]
比較条件として、失敗1,822件と成功9件からなる基本データでは溶媒の組合せのTop-3精度が約65%だったのに対し、成功2,603件を追加したデータでは約87%になった。Top-3精度とは、AIが挙げた上位三候補の中に正解が入る割合である。論文の概要には91%という値も示されているが、評価条件が異なる数値を混ぜず、ここでは本文中の同一比較条件を用いる。[15]
| 研究 | データ | 結果と読み方 |
|---|---|---|
| Nature(2016) | 研究ノートの成功・失敗を含む合成記録 | モデル提案条件の成功率89% |
| Chemical Science(2023) | 企業実験ノート由来781反応 | 収率予測の決定係数は最大0.266 |
| JACS Au(2026) | 失敗1,822件と成功2,603件 | 同一比較条件で溶媒Top-3精度約65%→約87% |
研究対象と評価指標が異なるため、三つの精度を直接比較できない。2026年のTop-3精度は上位三候補に正解が含まれる割合。
三つの研究は材料や反応、予測対象が異なるため、成功率や精度を直接比べることはできない。2016年の研究は未公表の試行を利用する価値を示し、2023年の研究は企業の記録を集めても予測が難しい条件を示し、2026年の研究は成功と失敗を整理して組み合わせる価値を示した。実験条件の組合せが膨大で、記録された試行がまばらなら、成功と失敗の両方が存在しても関係を学習しきれない。実験の選び方、結果の記録方法、測定のばらつきが予測の成否を左右する。
AIと実験が繰り返す、条件の改善
冒頭の2026年の研究は、過去の実験データを学習に使う段階から一歩進んでいる。論文から抽出した合成手順を検索し、候補の条件をAIが提案する。研究者が実験して実際の生成相を調べ、その結果をもう一度AIに伝える。こうして実験を重ねるたび、次の提案に新しい情報が加わる。[1]
実験条件の提案、実施、観察結果の記録を繰り返すことで、新しい結果を次の条件選定に反映できる。
この方式は、過去のデータだけでモデルを作って終える方法と異なる。研究の実行過程そのものが新しいデータを生み、そのデータが次の判断を支える。文脈が途切れず残れば、AIの提案と実験結果の対応も追いやすくなる。
実験装置の自動化も進んでいる。AIが条件を決め、装置が合成と測定を行い、結果を次の条件へ反映する「自律実験室」はその代表例である。しかし、測定結果をAIが正しく判定したかという確認も欠かせない。米国のA-Lab研究では、当初の成果について回折データの再解析が行われ、2026年1月の訂正では57標的に対する36化合物の合成成功が報告された。[6]
実験を繰り返す速さとともに、結果の判定を後から検証できる記録が重要になる。生データ、解析条件、判断の履歴を残す理由はここにある。
研究ノートからAIが使える実験記録へ
研究の現場では、個人のノート、表計算ファイル、装置の保存領域、報告書などに情報が分かれて残ることがある。保存されたことと、組織で再利用できることは別である。先の研究者調査でも、保存している回答者が多数いた一方、学術誌で共有した経験は一部にとどまっていた。[14]研究者が内容を知っている間は使えても、担当者が替わったり、別の部署が利用したりすると、試料と測定値、操作条件の対応をたどる負担が大きくなる。
例えば「目的物が得られなかった」という結果でも、反応が進まなかった場合、別の物質ができた場合、装置異常で測定できなかった場合では意味が違う。未実施、未測定、低性能、目標未達を区別し、どこまで実験したかを記録しておけば、AIに誤った教師情報を与える危険を減らせる。
研究データを一定の構造で残す仕組みが重要になる。日本で2024年に制定されたJIS K 0200:2024「MaiML」は、計測分析装置のデータを共通の形式で扱うための規格であり、実験や計測の過程を記録する手掛かりとなる。日本分析機器工業会(JAIMA)は2026年2月時点で、ISOへの新規国際規格提案に向けた活動を進めている。[7]
ただし、MaiMLがあれば失敗原因が自動で分類されるわけではない。共通の記録形式と、研究テーマごとの成否判定・原因分類は別の問題である。記録する項目を決め、装置から取れる情報を自動的に取り込み、研究者が判断した理由も必要に応じて残す。技術と研究現場の運用を組み合わせる必要がある。
100万件の蓄積と、日本の研究データ基盤
日本では、実験データを個々の研究室の外でも使える形に整える事業が動いている。文部科学省のマテリアル先端リサーチインフラ(ARIM)は、国内26機関の共用設備から生まれるデータを構造化し、事業開始後四年間で100万件超を蓄積した。2025年9月には、そのうち約11万件の共用を始めた。[8]
| 区分 | 件数 | 対象時点 |
|---|---|---|
| 構造化データの蓄積 | 100万件超 | 事業開始後四年間 |
| 共用を開始したデータ | 約11万件 | 2025年9月開始時点 |
100万件超は総蓄積件数、約11万件は共用開始時に利用可能となった件数。2026年10月時点の共用総数を示すものではない。
ARIMの公表資料によると、データには測定結果だけでなく、試料情報、実験条件、合成・加工プロセスの情報が結び付けられており、成功に至らなかった実験も含まれる。数字で重要なのは、蓄積した100万件超と、当初共用できた約11万件を区別することである。前者は集めたデータ、後者は一定の非共用期間を経て利用可能になったデータである。[8]
記録を促す制度は機関ごとに異なる。原則として広く登録を求める機関がある一方、産総研の先端ナノ計測施設では登録を強く推奨し、同意した利用者の料金上昇幅を抑える運用を案内している。[9] データを蓄積するには、登録作業を負担として増やすだけでなく、利用者に利点を設計する必要があることが分かる。
2027年度に向けた日本の概算要求でも、AIによる科学研究の高度化や研究プロセスの蓄積が政策課題として掲げられている。ただし、概算要求は政府が要求・要望する段階であり、成立した予算ではない。研究データの蓄積を国が重視する流れと、実際に現場でどこまで使えるデータを残せるかは分けて評価する必要がある。
実験データが生む開発効率と新しい事業
文脈を持った実験データの価値は、AIの予測精度だけで決まるものではない。研究者が以前の試行を探し直す時間、同じ条件をもう一度試す回数、開発を別拠点へ引き継ぐ際の負担にも関わる。
半導体製造装置のLam Researchなどによる2023年の研究では、実データで較正した仮想プロセスを使い、熟練技術者と最適化アルゴリズムの組合せを比較した。最も成績の良かったシニア技術者の目標到達コストは10.5万ドル。人間が途中まで探索した情報をアルゴリズムに引き継ぐ方式では、コストの中央値が5.2万ドルとなった。[10] ただし実際の製造ラインにおける費用削減の実績ではない。専門家の知見をどの段階で、どれだけ渡すかが探索効率に関係するという実証である。
企業にとっての収益化の形も複数ある。第一に、自社の研究データを再利用して材料開発の時間とコストを減らすこと。第二に、記録・検索・分析・接続を支えるソフトウェアやサービスの利用料を得ること。第三に、独自の実験データとAI、実験設備を組み合わせ、新しい材料や製品の開発力を高めることだ。
| 価値の生み方 | 具体的な形 | 収益・効果の位置づけ |
|---|---|---|
| 社内の開発効率改善 | 過去の実験の再利用と探索コスト削減 | 費用・時間の削減 |
| 記録・検索・解析サービス | データ基盤・分析ソフト・装置接続 | 利用料・継続収益 |
| 独自の材料・製品開発 | 実験とAIで自社知識を蓄積 | 競争力と材料・製品の価値 |
売上・利用料・開発費削減・製品収益は異なる指標であり、データそのものの販売額と同一ではない。
半導体向け製造データ解析などを提供するPDF Solutionsは2025年に2.19億ドルの売上を計上し、同社によれば継続収入は2.05億ドルだった。[11] これは失敗データ単独の売上ではなく、製造データの分析・接続を含む事業全体の数字である。新興企業CuspAIによる材料探索基盤への投資も、データ、計算、実験を結び付ける領域への関心を示している。ただし資金調達額を研究開発効果や市場規模と混同してはならない。
材料探索では記録の分散と実験条件の再現が課題になる一方、半導体などの製造工程では不良や歩留まりのデータが蓄積されていても、企業や工程の間で共有する範囲が課題になる。研究段階と量産段階を一律に分けられるわけではないが、文脈が途切れる場所は異なる。材料の開発から製品の製造・信頼性評価に進むと、データが企業をまたぐ問題も出てくる。材料メーカーの配合情報と顧客の製造条件や不良情報を結び付けられれば、原因の分析は進めやすい。一方、それらは競争上重要な機密情報でもある。三菱ケミカルと大塚化学は2025年、互いの実験データを秘匿したまま共同で機械学習に利用する取り組みを発表した。企業発表では従来二〜三年かかる開発を一年未満に短縮したとされるが、他の材料への一般的な効果を示す数字ではない。[16] データの利用価値と、利用できる範囲の設計を同時に考える必要がある。
研究の経験を組織の知識に変える
実験の成功は新しい知識を生む。期待と異なる結果も、条件と結果が結び付いていれば、次の探索を変える材料になる。AIにとって両方が重要なのは、成功と失敗を同じように扱うからではない。どのような条件からどのような結果が生まれたかという関係を、より広く学ぶためである。
過去の研究ノートをAIに読み込ませることから、実験中にデータを取り込み、次の実験へつなげることへ。さらに、組織や企業の壁を越えてデータを使う仕組みへ。材料研究開発では、データを集めることと、その背景を残すことが一体の課題になっている。
研究開発の資産として残すべきなのは、優れた結果の一覧だけではない。どの条件を選び、何を観察し、どのように次の判断へつなげたかという、探索の記録全体である。
参考情報・一次資料
- [1]Jeon et al., Closed-Loop Solid-State Synthesis Planning for Materials Discovery With Large Language Models, Advanced Materials (2026) — 実験とAIを反復する研究、4,407本の公開論文。
- [2]Zhuang et al., Materials Databases: Foundations of Modern Digital Materials, Precision Chemistry (2026) — メタデータ、来歴、失敗結果の分類。
- [3]Jia et al., Anthropogenic biases in chemical reaction data hinder exploratory inorganic synthesis, Nature (2019) — 17%・79%、548実験。
- [4]Raccuglia et al., Machine-learning-assisted materials discovery using failed experiments, Nature (2016) — 研究ノートと成功率89%。
- [5]Saebi et al., On the use of real-world datasets for reaction yield prediction, Chemical Science (2023) — 781反応と収率予測。
- [6]Szymanski et al., Author Correction: An autonomous laboratory for the accelerated synthesis of inorganic materials, Nature (2026) — A-Lab訂正。
- [7]JAIMA、AIST SolutionsとのMaiML普及協定(2026) — JIS K 0200、ISO提案に向けた活動。
- [8]文部科学省、ARIMデータ共用開始(2025) — 26機関、100万件超、約11万件。
- [9]産総研ANCF、利用料金改定のお知らせ — データ登録推奨と料金制度。
- [10]Kanarik et al., Human–machine collaboration for improving semiconductor process development, Nature (2023) — 仮想プロセスでの人間・AIの協働。
- [11]PDF Solutions、2025年業績についての公式解説 — 売上2.19億ドル、継続収入2.05億ドル。
- [12]文部科学省、令和9年度概算要求関連資料(提供された原本リンク) — 原本取得に制約があり、本文の確定数値には使用せず。
- [13]Open Reaction Database, JACS (2021) — 成否を含む記録の設計。
- [14]Herbet et al., Dissimulate or disseminate? A survey on the fate of negative results, Learned Publishing (2022) — 310人調査、87%保存、66%文書化、12.5%学術誌掲載。
- [15]Ma et al., Data-Driven Synthesis of Covalent Organic Frameworks via Machine Learning with Integrated Success–Failure Data, JACS Au (2026) — 失敗1,822件・成功2,603件と溶媒予測Top-3精度の条件別比較。
- [16]三菱ケミカルグループ、秘密計算技術を活用した大塚化学との共同開発(2025) — 企業発表による共同開発事例。
