
耐熱材料の寿命データには、取得に10年以上かかるものがある。長い時間と費用をかけて蓄積したデータほど、他社に渡す判断は難しい。一方で、一社のデータだけでは学習できる範囲に限界がある。材料開発でAIを本格的に使うほど、「もっとデータが必要」と「データは出せない」が正面からぶつかる。
2025年3月、物質・材料研究機構(NIMS)は、IHI、川崎重工業、関西電力、神戸製鋼所、電源開発、三菱重工業の6社と、NIMS、日本原子力研究開発機構の2国研が持つデータを相互に開示せず、耐熱鉄鋼材料の長期耐久性を予測する機械学習モデルを構築したと発表した。使われたのは連合学習である。各機関の元データを一か所に集めず、それぞれの環境で学習し、学習結果を統合する。[1]
同じ方向は秘密計算でも進んでいる。三菱ケミカルと大塚化学は、EAGLYSの秘密計算技術を使い、2024年7月から企業間の実データを連携した。4社の公表によれば、通常なら早くても2~3年かかる材料開発を1年未満に短縮し、顧客へサンプル提供できる水準の材料に到達した。[2] 2026年3月には、巴川コーポレーション、日立ハイテク、EAGLYSが電池・半導体領域で秘密計算AIを使う企業間実証を始めている。[3]
材料データを「見せずに使う」技術は、研究室の構想から企業間の実証や商用利用へ進んできた。
次に問われるのは、もっと別のことである。
秘密計算は「出しても怖くない」を作る。
次に必要なのは「出した方が得だ」を作る仕組みである。
ここでいう「怖くない」は、リスクがゼロになるという意味ではない。元データを相手に直接渡さずに共同利用できることで、情報提供の大きな障壁を一つ下げられる、という意味である。
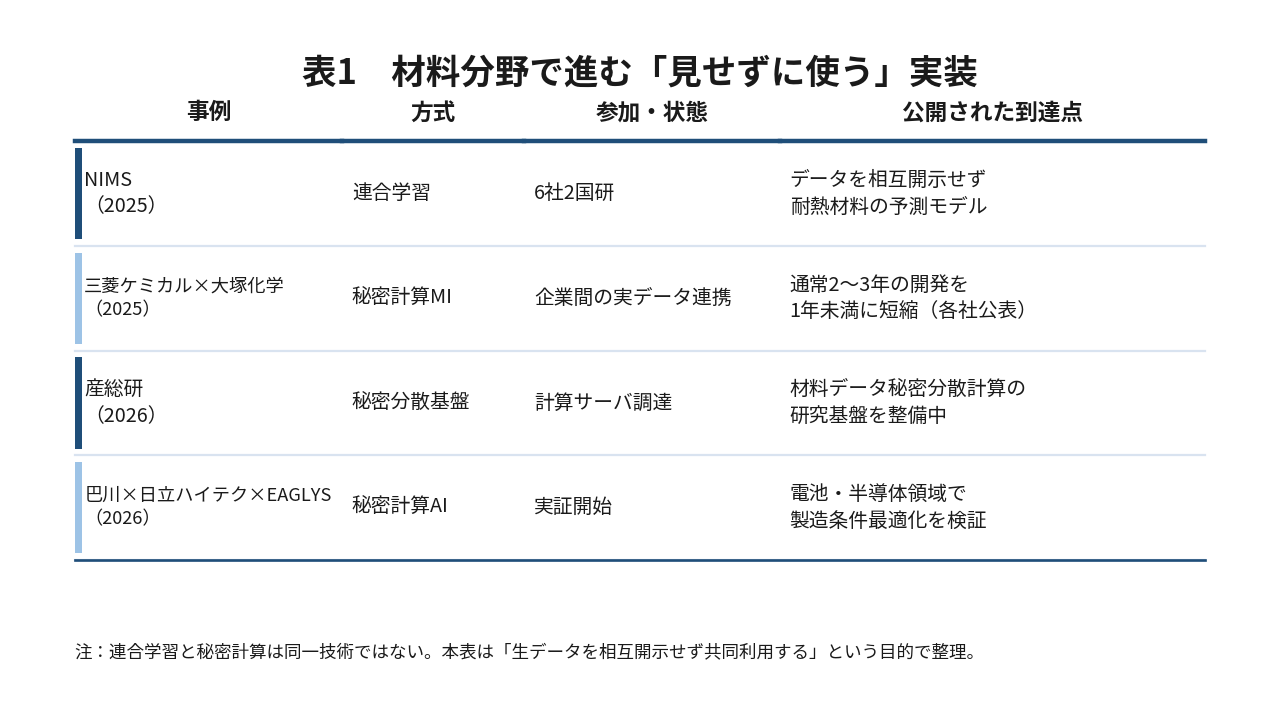
6社2国研が、データを見せずに一つのモデルを作った
材料開発でデータ共有が難しい理由は分かりやすい。配合、焼成条件、成膜条件、失敗実験、評価結果の組み合わせそのものが、企業の研究開発ノウハウだからである。
NIMSの事例では、6社2国研が元データを互いに見せずに学習へ参加した。NIMSは、NIMSのデータだけで作ったローカルモデルより予測精度が大幅に向上したと説明している。[1] 「共有するほどモデルは良くなる。しかし元データは渡したくない」という材料開発の典型的な衝突に、一つの実装解が示された。
三菱ケミカルと大塚化学の事例は、さらに企業間開発へ踏み込んでいる。公表資料には、従来は機密保持のため「具体的かつ定量的なデータは極力隠す」姿勢が基本だったと記されている。秘密計算を使った取り組みでは、両社が積極的にデータを提供し、定量的な議論が可能になったという。[2]
重要なのは、暗号方式の名前そのものではない。従来は「相手に見えるから出せない」と判断していた情報について、「相手に見せずに計算へ使う」という選択肢が生まれたことである。
連合学習と秘密計算は同じ技術ではない。前者はデータを各拠点に置いたまま学習する方式であり、後者にはMPC(マルチパーティ計算)、準同型暗号、TEEなど複数の方式が含まれる。本稿では技術を一括りにせず、「生データを相互開示せず共同利用する」という共通の目的に注目する。
秘密計算が作る「出しても怖くない」
秘密計算の強みを理解するには、「入力」と「出力」を分けるとよい。
国連のPrivacy-Enhancing Technologies(PETs)ガイドは、機密データを扱う技術を大きくInput PrivacyとOutput Privacyに分けている。Input Privacyは計算に使う元データを他者に見せないこと、Output Privacyは計算結果から元データを推測される危険を抑えることである。[4] 英国ICOも、Secure Multiparty Computationは入力の秘匿を提供する一方、出力自体には個人情報が含まれ得るため、出力の保護は別に考える必要があると整理している。[5]
材料開発に置き換えると理解しやすい。
A社が配合条件、B社が評価結果を持っているとする。秘密計算を使えば、互いの元データをそのまま見ずに予測モデルを作ることができる。しかし、完成したモデル、推奨された次の実験条件、最適組成の候補を誰が見られるかは別の話である。その結果を別案件にも使えるのか、第三者へ提供できるのか、そこから生まれた発明は誰のものかも暗号方式だけでは決まらない。
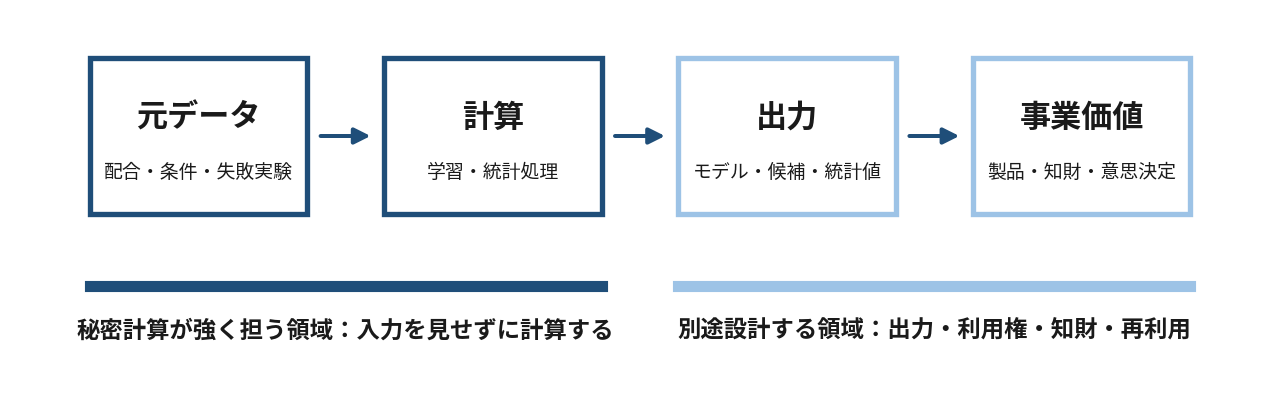
秘密計算が主に小さくするのは、「元データを相手に見せる怖さ」である。
企業が共同研究へ参加するときに考える範囲は、その先まで続いている。
計算の外に残る、出力・権利・離脱
材料データには、法律上の「所有権」をそのまま当てはめにくい。経済産業省の「AI・データの利用に関する契約ガイドライン」は、データを利用して生じる派生データや知的財産権について、契約で利用権限や帰属を明らかにすることを勧めている。[6]
同ガイドラインのデータ提供型モデル契約には、興味深い複数案が並ぶ。
一つは、派生データの利用権を受領者側に置く案。もう一つは、提供者にも利用権を与え、派生データを使った事業で売上が発生した場合に、その一定割合を支払うレベニューシェア案。さらに、帰属を案件ごとの協議に委ねる案もある。[6]
ここにはすでに「データを出した側へ価値を戻す」という発想がある。
一方、今回確認した材料分野の主要な公開事例では、データ利用範囲、成果物の帰属、離脱時の扱い、参加社間の貢献配分といった契約の詳細は公開されていない。技術成果は外から見えるが、「どのような条件なら各社がデータを出す決断をしたのか」は見えにくい。添付リサーチでも、NIMSの連合学習、EAGLYS系、旭化成×NECの三事例について、この契約条件の非公開性が共通点として確認されている。
ここが材料データ共有の次の論点になる。
さらに、企業間連携では「先に出す側」の扱いも重要になる。最初の参加者は、データの価値や利用範囲がまだ見えにくい段階で提供判断をする。後から参加する企業は、先行企業が作った枠組みや学習済みの成果を利用できる場合がある。参加時期による負担と便益の差をどう扱うかが曖昧なら、価値の高いデータを持つ企業ほど様子を見る合理性が生まれる。ここは暗号性能では解けず、参加条件、利用権、優先権などの設計で扱う領域である。
企業が知りたいのは「漏れないか」だけではない。
自社が多くのデータを出したとき、何が戻るのか。希少な失敗データを提供した会社と、一般的なデータを提供した会社を同じに扱うのか。共同モデルから大きな利益が生まれたとき、その価値は誰に帰属するのか。途中でプロジェクトを離れた後も、自社データで学習したモデルは使われ続けるのか。
秘密計算の導入によって、この問いが消えるのではなく、むしろ輪郭がはっきりする。
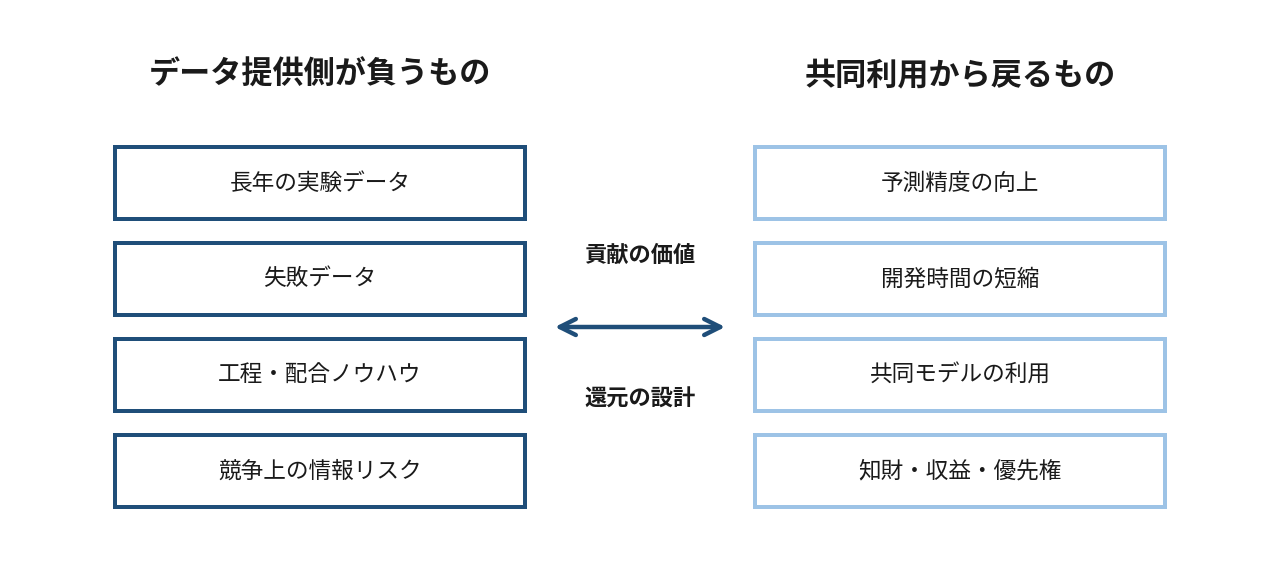
6社2国研——少数参加で変わる「秘密」の意味
材料分野では、秘密の意味をもう一段細かく考える必要がある。
金融や医療と比べて、単純に「参加企業数が少ない」と整理するのは正確ではない。企業や病院などの組織が参加するcross-silo federated learningは、一般に100組織以内の比較的小規模な構成を想定する。[8]
違いは、参加主体の数だけではなく、一社が持つデータの競争上の意味にある。
金融機関や医療機関では、一つの組織の中に多数の顧客・患者・取引などのレコードが存在する場合が多い。一方、材料開発では、データ件数が少なくても、配合、工程、失敗条件、長期耐久性の結果そのものが競争力に直結し得る。NIMSも、材料データは取得に時間とコストがかかり、「各社の競争力の源泉」であるため共有が難しいと説明している。耐熱材料の寿命データには取得に10年以上かかるものもある。[1]
参加企業が少数で、各社の得意領域も知られている市場では、集計結果だから直ちに安心とは限らない。EUの水平協力ガイドラインも、集計情報の競争上の評価では、個別企業への帰属が十分に困難かどうか、市場がどれだけ集中しているかといった条件を考慮している。[9]
これは「秘密計算でも必ず個社データが推定できる」という意味ではない。むしろ、少数の既知企業で共同利用する材料データでは、元データを隠すことに加えて、どの出力を誰に見せるか、個社への帰属をどこまで推測できるかを個別に検討する必要があるということである。
そして、事業会社にとっては、漏洩とは別の問題がある。
自社が長年蓄積したデータを共同モデルに入れ、その結果として競合企業も高性能なモデルを使えるようになるなら、「データそのものは漏れていないが、自社と競合との差は縮まる」という状況が起こり得る。
2024年のIEEE Communications Magazineの論文は、cross-silo型の共同学習では、市場競争そのものが企業間協力を弱める要因になると整理している。企業は競合に高品質なモデルを持たせることを望まないためである。同論文は、この問題に対して収益分配などの経済メカニズムを検討しているが、一般解が確立したという位置づけではない。[10] 2021年のIEEE INFOCOM論文も、共同モデルを参加者から排除しにくい「公共財」と捉え、参加インセンティブを設計課題として扱っている。[11]
ここで秘密計算の限界がはっきりする。
秘密計算は「情報を奪われるリスク」を小さくできる。
しかし、「自社データで競合まで強くなるコスト」は消せない。
10社の製薬企業が、権利でデータ拠出を促した
事業会社で「出す理由」を設計した参考例が、製薬業界のMELLODDYである。
MELLODDYには10社の製薬企業が参加し、各社の機密データを中央へ集めずに共同学習を行った。特徴は、秘密性の確保だけで終わらず、共同学習で作るモデルの権利構造まで設計したことである。
モデルは、参加者で共有する部分と、個別タスクに対応する専用部分に分かれる。論文では、特定タスクのラベルを提供したタスクオーナーが、そのタスク固有のヘッドモデルを排他的に所有する。そして、より多くのタスクとデータを参加させることで、より多く、より良い自社専用モデルを得られる見込みが、データ拠出を促すと説明している。[7]
つまり、共同モデルの価値を全員に同じ形で配るのではなく、共同部分とは別に、参加企業が自社で取り込める専用価値を残した。
これは、事業会社のデータ共有を考える上で重要なヒントである。
ただし、MELLODDYが「誰のデータがどれだけ価値を生んだか」を測り、その貢献度に応じて便益を精密に配分したわけではない。公開情報から確認できるのは、タスクオーナーに専用モデルを帰属させ、より多くのタスク・データ参加を促す設計までである。
材料分野ではさらに難しい。百件の一般的な測定データより、一件の希少な失敗条件や十年以上かけて得た寿命データの方が重要かもしれない。また、A社とB社のデータを組み合わせて初めて予測精度が上がるなら、価値を単純に一社へ帰属させることもできない。
秘密計算によって、「どう守るか」は解け始めた。
しかし、「誰がどれだけ価値を提供し、その価値をどう返すか」はまだ解けていない。
「秘密性・出力・権利・事業合理性」の四層
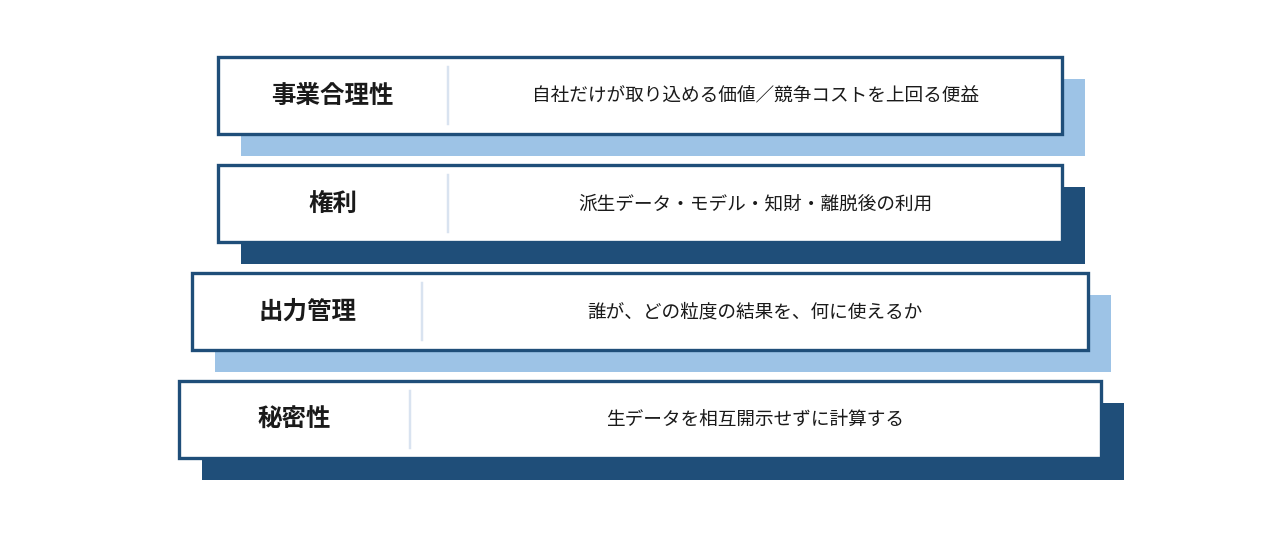
材料データ共有には、少なくとも四つの設計が必要になる。
第一層は秘密性。生データを相互開示せずに計算する。秘密計算や連合学習が主に担う領域である。
第二層は出力管理。誰がどの結果を見られるか。統計値、モデル、推奨条件など、出力の粒度と利用範囲を決める。
第三層は権利。派生データ、モデル、発明を誰が使えるか。途中離脱した後の利用も含めて決める。
第四層は事業合理性。ここが事業会社では最も難しい。データを提供した結果、競合も強くなる可能性を含めても、自社が参加する方が合理的だと判断できる価値を設計する必要がある。
その価値は、単なる現金報酬とは限らない。自社専用モデル、提供者だけが使える高度機能、優先アクセス、特定用途での利用権、知財、収益分配などが候補になる。
重要なのは、共同利用から生まれる「全員の便益」と、データを出した企業が自社で取り込める「専有的な便益」を分けて考えることである。
ここで新しい問題が生まれる。
その専有的な便益を、誰に、どの程度与えるべきか。件数、希少性、再現性、取得コスト、モデル性能への寄与、提供時期など、貢献の測り方自体がまだ定まっていない。組み合わせで初めて価値が生まれるデータでは、一社ずつの貢献を切り分けることも難しい。
つまり、次の課題は「報酬をつければよい」ではない。
事業会社が共同化によって失う競争優位を上回る「自社だけが取り込める価値」を、どう設計するか。
これが、秘密計算を企業間の材料データ共有へ広げる上で、まだ解けていない課題である。
秘密計算の次に残る、事業モデルの難問
材料開発では、「機密データを守ること」と「企業をまたいでデータを使うこと」が長く対立してきた。
秘密計算や連合学習は、その対立の一部を技術で小さくする。NIMSの6社2国研の連携や、三菱ケミカルと大塚化学の材料開発は、その可能性を具体的に示している。産総研でも2026年8月に「材料データ秘密分散計算サーバ」の調達が公告されており、研究基盤の整備は続いている。[12]
しかし、事業会社の意思決定は「漏れない」だけでは終わらない。
自社のデータを提供することで共同モデルが良くなり、その便益を競合も得るなら、データ提供は自社の相対的な優位を縮める可能性がある。逆に、参加企業全体の便益だけを強調しても、価値あるデータを持つ企業ほど参加をためらう構造が残る。
だから、今の結論はここにある。
秘密計算によって、「どう守るか」は解け始めた。
しかし、「誰がどれだけ価値を提供し、その価値をどう返すか」はまだ解けていない。
そして事業会社では、単に価値を返せばよいわけでもない。
共同化によって失う競争優位を上回る「自社だけが取り込める価値」を、どう設計するか。
MELLODDYは専用モデルという一つの答えを示した。cross-silo FLの研究では収益分配なども提案されている。しかし、材料データについて、どの貢献をどう評価し、どの専有価値を返せば企業が継続的に参加するのかという実務的な仕組みは、まだ確立していない。
秘密計算の次の難問は、暗号方式だけではない。
データを出す企業にも競争上の合理性が生まれる事業モデルを、どう設計するか。
材料データが本当に動き始めるかどうかは、ここにかかっている。
参考情報
- [1]NIMS「データを隠したまま機械学習モデルを構築
~6社2国研の産学データ連携で幅広い耐熱材料の長期耐久性を予測~」(2025-03-13)
https://www.nims.go.jp/press/2025/03/202503130.html - [2]三菱ケミカル・大塚化学・三井物産ケミカル・EAGLYS「材料開発期間短縮に関する4社連名発表」(2025-07-28)
https://www.mcgc.com/news_release/pdf/02395/02654.pdf - [3]EAGLYS「巴川コーポレーション、日立ハイテク、EAGLYSによる電池・半導体領域の企業間データ連携実証」(2026-03-19)
https://eaglys.co.jp/resource/news/260319 - [4]United Nations, Guide on Privacy-Enhancing Technologies for
Official Statistics
https://unstats.un.org/bigdata/task-teams/privacy/guide/ - [5]UK Information Commissioner's Office, Privacy-enhancing
technologies (PETs)
https://ico.org.uk/for-organisations/uk-gdpr-guidance-and-resources/data-sharing/privacy-enhancing-technologies/ - [6]経済産業省「AI・データの利用に関する契約ガイドライン 1.1版
―データ編―」
https://www.meti.go.jp/policy/mono_info_service/connected_industries/sharing_and_utilization/20200619002.pdf - [7]MELLODDY: Cross-pharma Federated Learning at Unprecedented
Scale Unlocks Benefits in QSAR without Compromising Proprietary
Information
https://pmc.ncbi.nlm.nih.gov/articles/PMC11005050/ - [8]Huang, C., Huang, J., Liu, X., “Cross-Silo Federated Learning:
Challenges and Opportunities”(2022)
https://arxiv.org/abs/2206.12949 - [9]European Commission, Guidelines on the applicability of
Article 101 of the Treaty to horizontal co-operation
agreements(2023), 6.2.3.2 Aggregated versus individualised
information
https://competition-policy.ec.europa.eu/system/files/2023-07/2023_revised_horizontal_guidelines_en.pdf - [10]Huang, C. et al., “Promoting Collaboration in Cross-Silo
Federated Learning: Challenges and Opportunities,” IEEE
Communications Magazine 62(4), 82–88(2024)
https://doi.org/10.1109/MCOM.005.2300467 - [11]Tang, M., Wong, V. W. S., “An Incentive Mechanism for Cross-Silo
Federated Learning: A Public Goods Perspective,” IEEE INFOCOM
2021
https://doi.org/10.1109/INFOCOM42981.2021.9488705 - [12]産業技術総合研究所「材料データ秘密分散計算サーバ」入札公告(2026-08-31)
https://www.aist.go.jp/aist_j/procure/supplyinfo/pub/detail/9HA0BOPR - [13]櫻井惇也ほか「クリープ破断時間および高温引張強度予測モデルの連合学習」『鉄と鋼』111巻5号,
pp.246–262(2025)
https://www.jstage.jst.go.jp/article/tetsutohagane/111/5/111_TETSU-2024-124/_article/-char/ja/ - [14]産業技術総合研究所「材料データを秘匿しながらベイズ最適化を行う材料探索アプリを開発」(2024-12-24)
https://www.aist.go.jp/aist_j/press_release/pr2024/pr20241224/pr20241224.html - [15]旭化成・NEC「秘密計算技術を活用した企業間データ連携の分析基盤を構築」(2023-03-28)
https://www.asahi-kasei.com/jp/news/2023/ze230328 - [16]「秘密計算を用いたデータ利活用実践のためのガイドライン【3.
秘密計算におけるデータ管理とセキュリティ編】ver.1」(2026-03-25)
https://secihi.ntt.com/lp/guideline/秘密計算におけるデータ管理とセキュリティ編.pdf - [17]「秘密計算システムを活用したデータ共有のための推奨要件」ver.1(2026-03-25)
https://secihi.ntt.com/lp/guideline/秘密計算システムを活用したデータ共有のための推奨要件.pdf - [18]NTTドコモビジネス「『秘密計算活用事例集』第2版および『秘密計算を用いたデータ利活用実践のためのガイドライン』を公開」(2026-03-25)
https://www.ntt.com/about-us/information/info_20260325.html - [19]European Commission CORDIS, MELLODDY project, Grant Agreement
831472
https://cordis.europa.eu/project/id/831472 - [20]内閣府「マテリアル戦略有識者会議 第14回
資料1-2 産総研におけるマテリアルDXの取り組み」(2026-03-05)
https://www8.cao.go.jp/cstp/material/14kai/siryo1-2.pdf
