
はじめに
ラボオートメーション、自律実験、スマートラボ。似た言葉が並びますが、指しているものは同じではありません。装置を一台入れて分注を自動化することも、AIが次の実験を決めて人手なしに回り続けることも、どれも同じ言葉で語られることもあれば、同じことが違う言葉で語られることもあります。
言葉の意味が曖昧なままだと話が噛み合いません。どこまでを機械に任せているのかを言い分けられるようにしておくと、いま何ができていて、次に何が要るのかが見えやすくなります。
「ラボオートメーション」に決まった定義はない
最初に、ラボオートメーションという言葉には、公式の定義が存在しないという点です。日本にも海外にもありません。
一方で、それを構成する要素には規格があるものがあります。自動で液体を扱う装置についてはISO 23783-1が用語と一般要求事項を定めています。実験に使う容器の寸法にはANSI/SLASの規格があり、マイクロプレートのフットプリントを127.76mm×85.48mmと決めています。分析データの形式については、日本発の規格としてJIS K 0200が2024年5月に制定されました。MaiMLと呼ばれるもので、メーカーの異なる装置から出たデータを同じ形式で扱えるようにするものです。
つまり、個別に一部の規格はあるけれど、全体を指す言葉の定義はない、という状態です。
規格は、物理的につなぐ必要があるものから順に整備されていきます。プレートの寸法が合わなければロボットアームが持てませんし、データ形式が違えば次の装置に渡せません。対して「ラボオートメーション」は概念であって、何かと接続する対象ではないため、規格化の動機が働きにくいのです。
公式の定義はないものの、定義に近い記述はいくつか公表されています。
一般社団法人ラボラトリーオートメーション協会は、次のように述べています。
ラボラトリーオートメーションは、研究開発のすべてのプロセスを対象に、AIやロボットを用いて自動化・自律化する取り組みです。その開発や実装のためには、システムの構成要素であるハードウェア、ソフトウェア、運用管理、応用分野(生命科学・材料・化学など)を高いレベルで融合することが求められます。
出典:一般社団法人ラボラトリーオートメーション協会 公式サイト
研究開発の全工程を対象とし、自動化と自律化の両方を含む、という広い捉え方です。
より中核部分に絞った整理もあります。東京大学と東京科学大学らの研究グループは、2025年5月の発表で自動実験と自律実験を次のように書き分けています。
「自動実験」は人間が指定した実験を、ロボットが繰り返し正確に進めることを意味する。一方、「自律実験」は、コンピュータが次に進める実験内容を指定し、ロボットが指示通りにその実験を実施する。そして、その実験結果をコンピュータにフィードバックし、次に取り組む実験内容を決定する。このサイクルをクローズドループと呼び、人間の関与無く、目的の材料を合成するまで物質空間を探索する。
出典:東京科学大学「欲しい物質を自動的・自律的に合成する」(2025年5月14日)
前者が取り組み全体を指すのに対し、後者は実験の進め方を二つに書き分けています。指している範囲が違うので、どちらが正しいというものではありません。
分かれ目は「次に何を試すかを誰が決めるか」
先に引用した書き分けを、もう一段かみ砕きます。
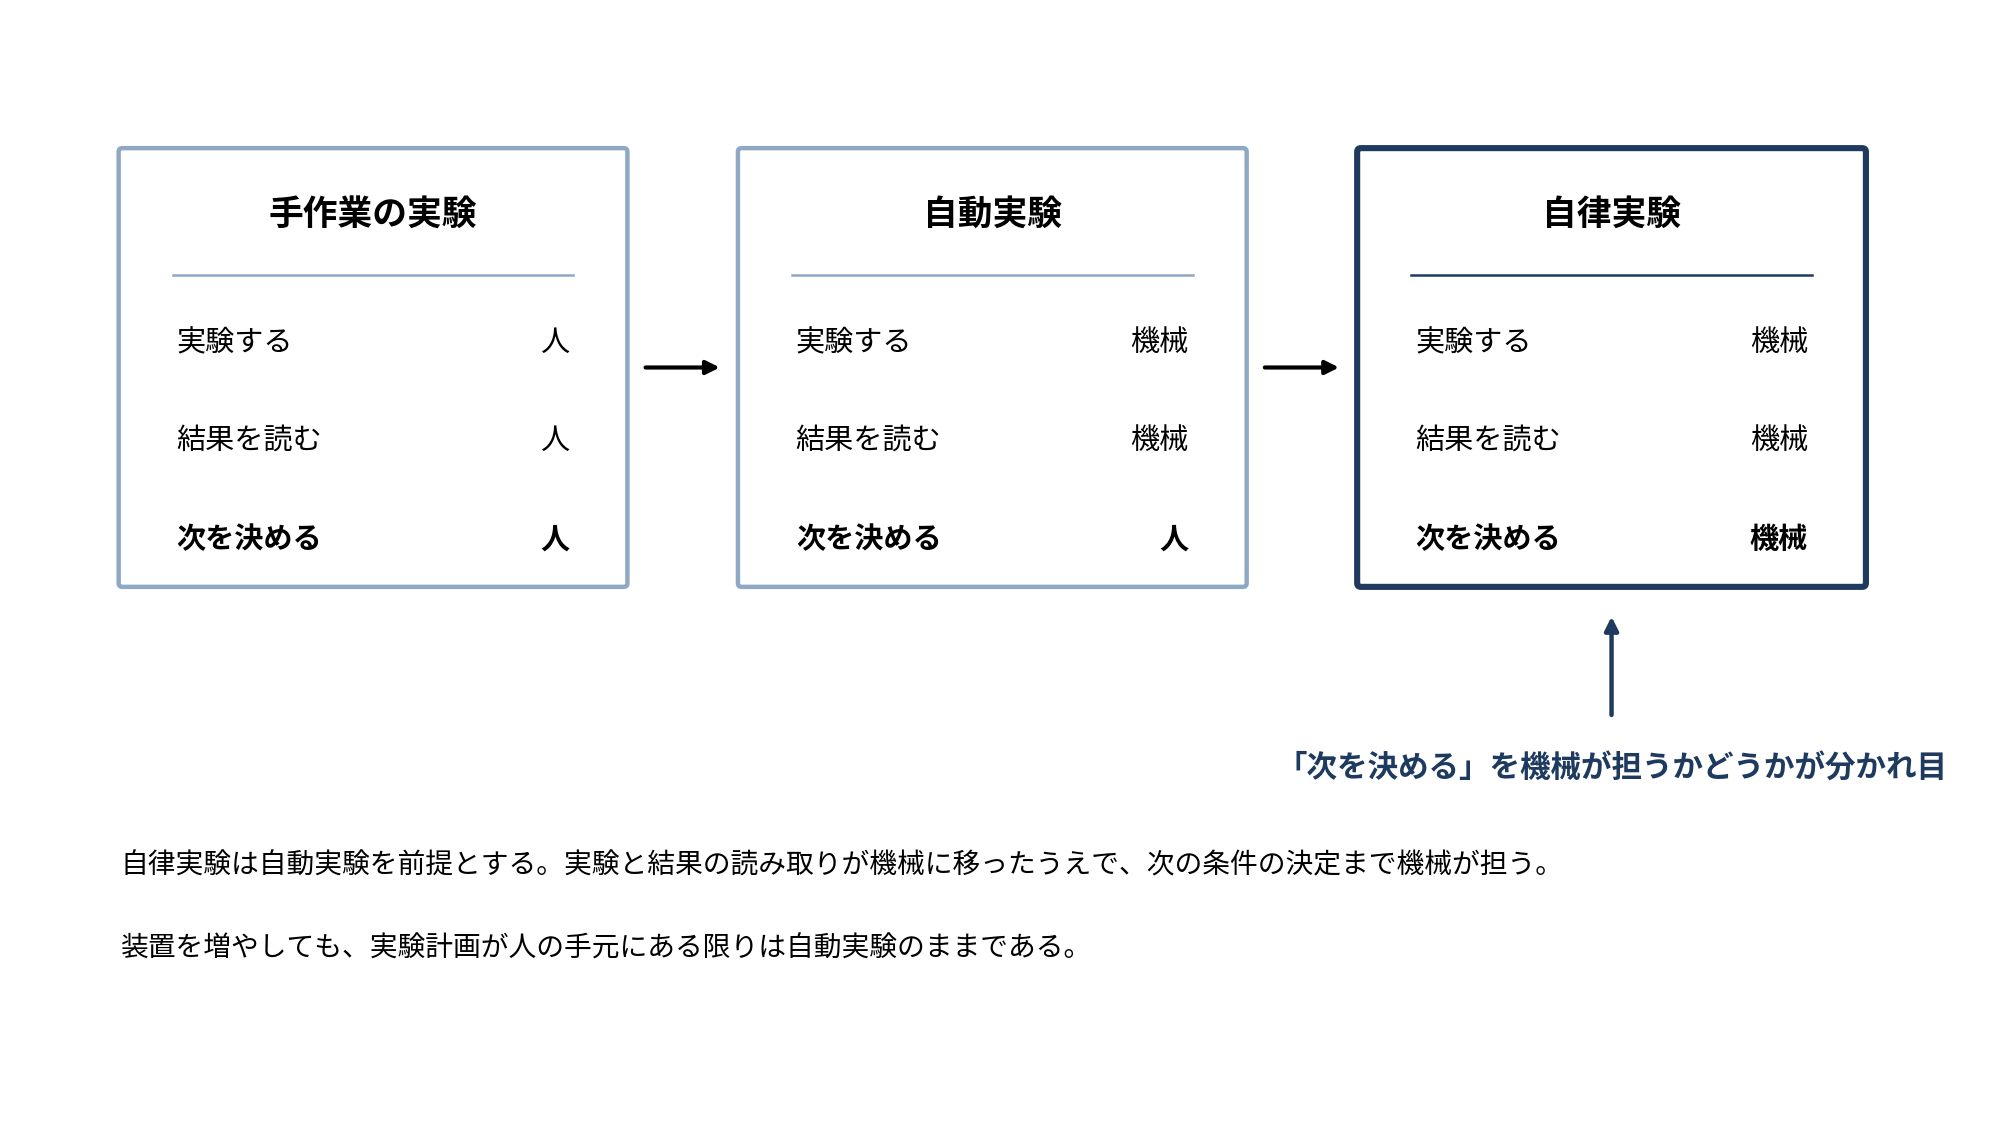
自動実験と自律実験の分かれ目は一点だけです。次に何を試すかを、人が決めているのか、機械が決めているのか。
ここで大事なのは、自動化を推し進めれば自律化に届く、という関係ではないことです。自律実験は自動実験を前提としますが、装置を増やしても、実験計画が人の手元にある限りは自動実験のままです。境目にあるのは装置の数ではなく、次の条件を誰が決めるかです。
規模の大きさは、自律性ではない
規模と自律性は、異なる指標です。
創薬で使われるハイスループットスクリーニングは、数万から数十万の化合物を短時間で評価します。これは高度に自動化された仕組みですが、自律実験ではありません。どの化合物をどの条件で評価するかが、あらかじめすべて決まっているからです。機械が担っているのは実行であって、判断ではありません。
逆に、装置が小さく実験数が少なくても、次の一点を機械が選んでいるなら、それは自律実験です。実験数の多さと自律性は、別の話です。
何を機械に任せているか
実際には、機械に任せられる判断はいくつかの段階に分かれていて、どこまで任せているかは事例ごとに違います。
四つに分けると見通しがよくなります。
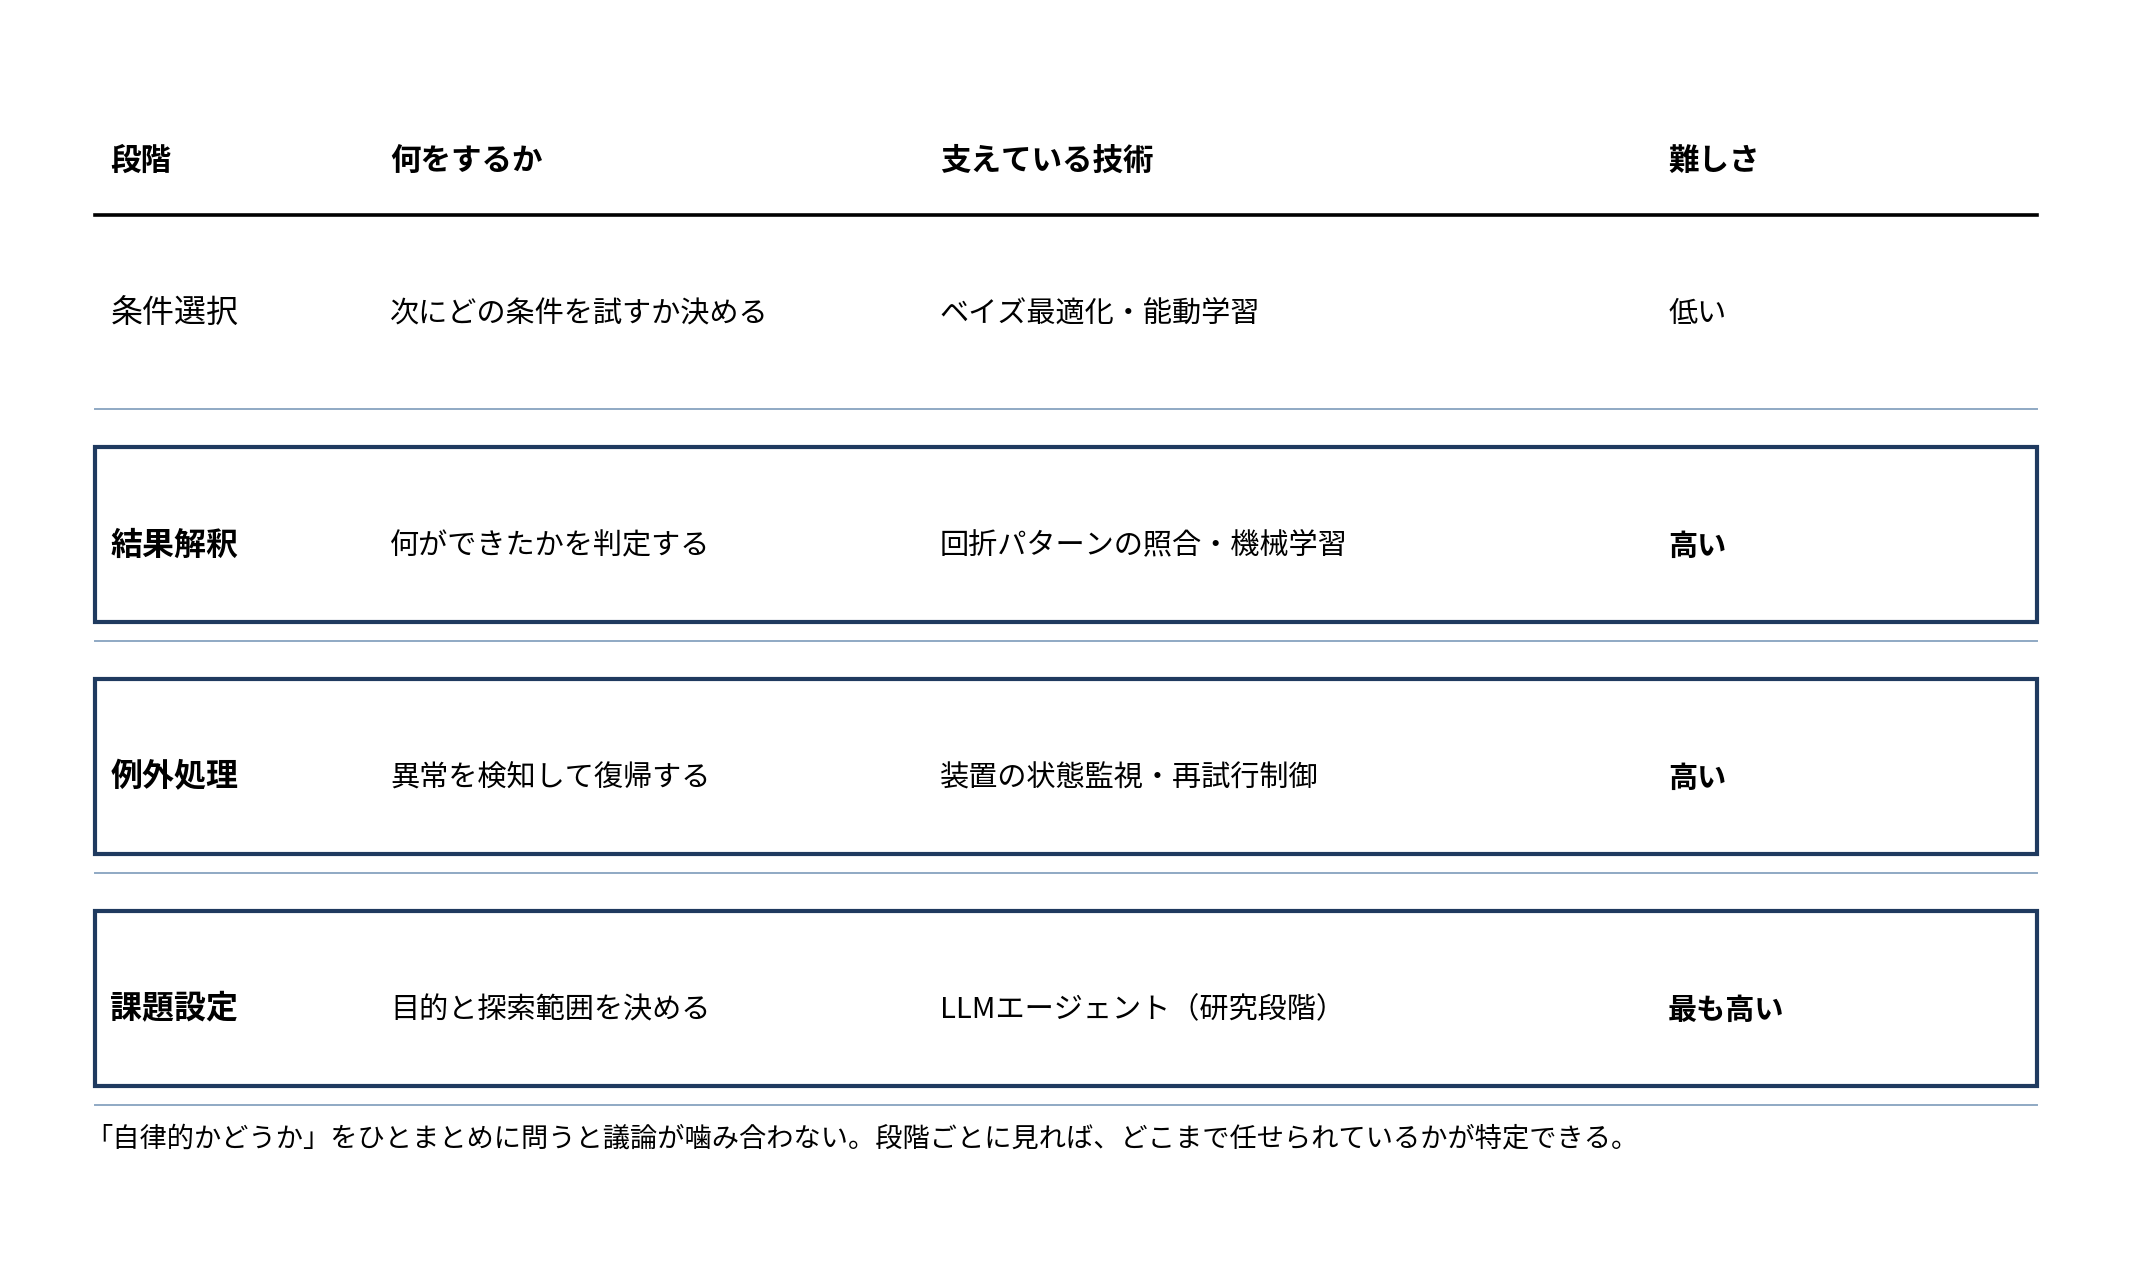
条件選択は、次にどの条件を試すかを決める段階です。結果解釈は、実験して得られたデータから何ができたかを判定する段階です。例外処理は、装置が詰まる、想定外の値が出るといった事態を検知して立て直す段階です。課題設定は、そもそも何を目的に、どの範囲を探すのかを決める段階です。
この四つは難しさがかなり違います。同じ「自律的」という言葉でも、条件選択だけを任せているのか、結果解釈まで任せているのかで、実現の難度は大きく変わります。
それぞれを支えている技術
条件選択――ベイズ最適化と能動学習
次の一点を選ぶ役割を担うのが、ベイズ最適化に代表される手法です。
中核にあるのはガウス過程回帰という統計手法で、これは予測値だけでなく、その予測がどれくらい不確かかを同時に出せます。獲得関数と呼ばれる指標が、有望そうな領域を掘り下げることと、まだ調べていない領域を試すことのバランスを取り、次に評価すべき条件を一つ選びます。実験結果が返ってくるたびにモデルを更新し、また次を選びます。
近い考え方に能動学習があります。こちらは予測モデルの精度を上げることを目的に、モデルが自信を持てていないデータ点を優先して取りにいきます。目的の違いはありますが、限られた回数で効率よくデータを集めるという点では同じ発想です。
この技術はソフトウェアで完結します。装置に手を加える必要がなく、オープンソースのライブラリも整っているため、四つの中では最も導入しやすい部分です。
結果解釈――照合と機械学習
測定したデータから何ができたかを判定する段階です。ここが材料分野では難所になります。
無機材料の判定によく使われるX線回折では、測定して得られた回折パターンを、既知の物質のパターンを収めたデータベースと照合します。指紋の照合に近い作業です。国際回折データセンター(ICDD)が管理するデータベースが広く使われており、市販の解析ソフトも複数あります。
ただし照合だけで決まらない場合があります。似た構造の別物質は似たパターンを出しますし、複数の物質が混ざっていればパターンも重なります。ここに機械学習を持ち込む研究が進んでおり、回折パターンから結晶の対称性を推定する手法などが報告されています。熟練者が経験的に行っている読み取りを、定式化しようという方向です。
それでも、確定できない場合をどう扱うかは残された課題です。人であれば疑わしいと感じた時点で別の測定を足しますが、機械にその判断をさせる仕組みはまだ一般的ではありません。
例外処理――状態監視と再試行
実験は計画通りには進まないことがあります。分注ノズルが詰まる、サンプルが所定の位置にない、炉の温度が上がりきらない。人がいれば気づいて対処することが、無人運転では止まる原因になります。
この段階を支えるのは、装置の状態を常に見張る仕組みです。センサやカメラで位置や量を確認し、想定と違えば再試行する、あるいは該当のサンプルを飛ばして次に進みます。
地味な領域ですが、連続運転の成否を分けるのは実質ここです。どれだけ賢いアルゴリズムを載せても、装置が朝方に止まっていれば探索は進みません。
課題設定――LLMエージェント
そもそも何を目的に、どの範囲を探すのか。ここまで機械に任せる試みが、大規模言語モデルの登場以降に現れています。文献を読んで仮説を立て、実験計画を組み、装置に指示を出すところまでを一つのエージェントが担う、という構想です。
研究としては報告が出ていますが、実用の段階には至っていません。提案の妥当性を誰がどう検証するか、安全に関わる判断をどう扱うかといった問題が残っているためです。四つの段階の中では、最も先の話になります。
これらをつなぐもの
四つの段階が個別に成立しても、それだけでは実験は回りません。装置とソフトウェアをつなぎ、順番を管理し、結果をためる仕組みが要ります。
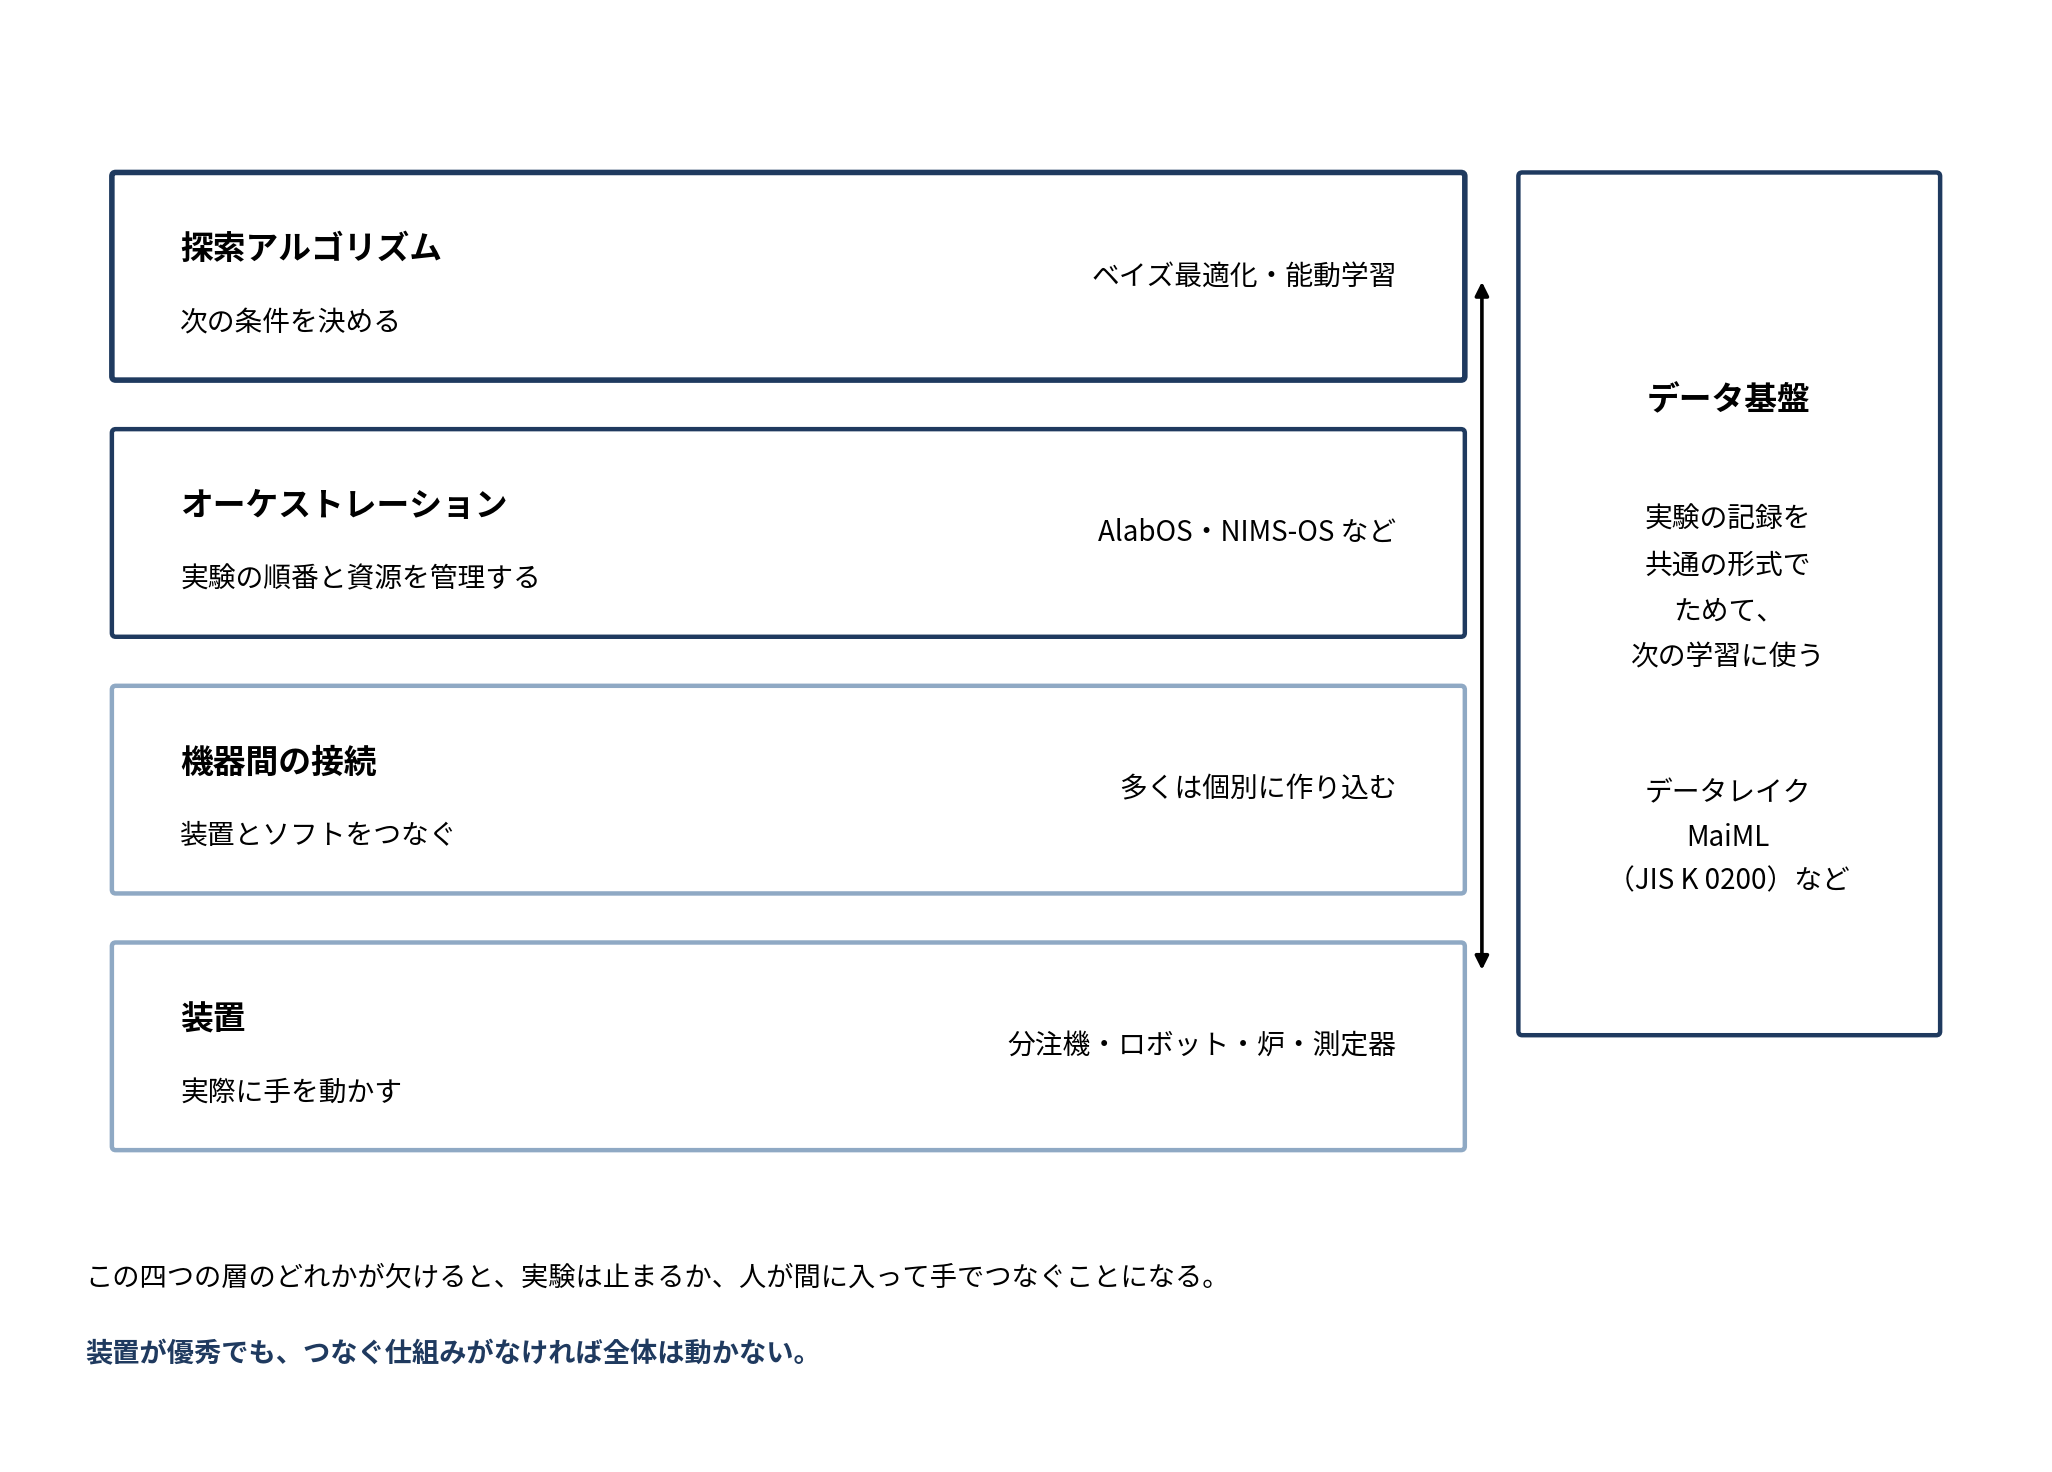
装置とソフトウェアをつなぐ部分は、いまのところ個別に作り込むことが多い領域です。装置ごとに通信の方式もデータの出し方も違うため、一台つなぐたびに変換のためのプログラムを書くことになります。メーカーに依存しない通信規格の策定も進んでいますが、対応する装置はまだ限られます。
実験の順番と資源を管理するのが、オーケストレーションソフトです。実験の流れを個々のタスクに分け、どの装置をいつ使うかを組み立てます。複数の実験を並行して走らせると装置の取り合いが起きるため、使用中の装置を予約しておき、衝突が起きないようにします。装置が停止したときにどう扱うかも、この層で決まります。
人が投入した実験と、探索アルゴリズムが投入した実験を、同じ入り口で受け付ける設計にしておくと、自律的な探索と手動の実験を一つの仕組みの上で回せます。
A-Labで使われているAlabOSがこれにあたり、1年半で約3,500サンプルの合成と評価を管理した実績が報告されています。NIMSが公開しているNIMS-OSも同種のソフトウェアで、ロボット実験装置と探索用AIをそれぞれモジュールとして扱います。
そして、これらすべてを横断するのがデータ基盤です。実験の記録を共通の形式でためておかなければ、次の学習に使えません。装置ごとにばらばらの形式で出力されたファイルは、そのままでは資産になりません。先に触れたMaiMLのような共通形式や、研究データを一元的にためるデータレイクの整備が、この土台にあたります。
四つの層のどれかが欠けると、実験は止まるか、人が間に入って手でつなぐことになります。装置を導入しただけでは自動化が進まないのは、このためです。
分解すると、事例の位置づけが決まる
四つの段階に分けて見ると、報道で見かける事例がどこにあるのかを整理できます。
ハイスループットスクリーニングは、四つのいずれも機械に任せていません。実行だけを自動化した仕組みです。
NIMSの電解質探索は、条件選択を機械が担っています。16種類の添加剤から5つを混ぜる組み合わせを、ベイズ最適化とロボット実験の連携で11サイクル探索しました。放電時間という数値が直接得られるため、結果解釈の段階は問題になりません。
A-Labは、条件選択に加えて結果解釈まで機械に任せています。合成した粉末をX線回折で測定し、狙った化合物ができたかどうかを自動で判定していました。2026年2月に出た著者訂正では、回折パターンだけでは存在を確定できない4件が成功数から除外されています。任せる範囲を広げたぶん、難所に踏み込んだ事例と言えます。
こうして並べると、同じ「自律実験」でも到達している段階が違うことが分かります。
言葉を分けて使うと、何が見えるか
用語を整理すること自体が目的ではありません。分けて使えるようになると、現状の把握と次の一手の検討がしやすくなります。
たとえば自社のラボで実験の自動化を検討するとき、どの段階を機械に任せたいのかを先に決めておけば、必要な投資の性質が変わります。条件選択だけならソフトウェアの導入で済みますが、結果解釈まで含めるなら測定の自動化とデータの整備が要ります。例外処理を織り込むなら、装置の状態を見張る仕組みが必要になります。
装置が自動で動くのと、実験が自律的に回るのは、別のことです。両者の要素を理解することが、この分野の理解と議論の出発点になります。
